Del envío de comandos y las transferencias PCIe a NVLink cifrado y la arquitectura de la pila de inferencia
La computación confidencial busca proteger los datos, los pesos del modelo y los estados intermedios de ejecución incluso frente al administrador de infraestructura, el sistema operativo anfitrión y el hipervisor. Para evaluar su coste hay que preguntar qué partes de la ejecución soportan sobrecarga, qué proporción de cada solicitud transcurre en ellas y cómo el software oculta o amplifica ese coste.
Un preprint reciente sobre computación confidencial en NVIDIA B200 presenta dos resultados aparentemente contradictorios: una sobrecarga de inferencia de aproximadamente el 1–3 % con una pila bien configurada y pérdidas del 30–40 % de rendimiento en algunas configuraciones sin corregir.
En el artículo sobre compatibilidad real con INT8 y FP8 vimos que admitir nominalmente un formato no garantiza su uso efectivo. En el de latencia y capacidad de procesamiento explicamos por qué la GPU más rápida no siempre produce la respuesta más rápida. Esta tercera entrega de la secuencia, dentro de la guía de selección de GPU, profundiza un nivel más: incluso manteniendo el hardware y el modelo, la arquitectura de seguridad y el software de inferencia determinan cuánto cuesta proteger los datos.
¿Qué se vuelve confidencial exactamente?
En el sistema estudiado, una máquina virtual confidencial con Intel TDX protege la memoria y el estado de la CPU frente al anfitrión. NVIDIA Confidential Computing extiende esa protección a la GPU.
La reflexión sobre seguridad de infraestructura desde el kernel hasta la GPU examinó el acceso a través de las capas inferiores. Aquí interesa el coste de proteger esas mismas fronteras:
- la memoria de la máquina virtual y el estado de la CPU;
- las transferencias entre la memoria del anfitrión y la GPU mediante PCIe;
- la memoria de la GPU;
- el envío de comandos al procesador de gestión de la GPU;
- la comunicación entre GPU mediante NVLink;
- y la cadena de atestación del hardware, el firmware y el entorno de ejecución.
En Intel TDX, la memoria privada de la máquina virtual se aísla del monitor de máquinas virtuales, o VMM, y del software anfitrión.
Según la guía de computación confidencial de NVIDIA, Blackwell admite NVLink cifrado en modo multi-GPU. Las transferencias CPU–GPU pueden utilizar búferes intermedios cifrados o, en plataformas compatibles, TDISP/IDE.
Activar el cifrado afecta, por tanto, a varias fronteras con patrones de coste distintos.
¿A qué sistema corresponden las mediciones?
Este artículo analiza la segunda versión del preprint, publicada el 1 de septiembre de 2026. Las mediciones son de sus autores; no son experimentos realizados para este artículo.
| Componente | Configuración del ensayo |
|---|---|
| Anfitrión | Servidor de dos procesadores Intel Xeon 6767P |
| GPU | Ocho NVIDIA B200 conectadas mediante NVLink |
| Entorno confidencial | Intel TDX y NVIDIA CC |
| Sistema operativo | Ubuntu 24.04.3 |
| Controlador del invitado | NVIDIA 595.71.05 Open Driver |
| Motores de inferencia | SGLang 0.5.13.post1 y una rama corregida; vLLM 0.21.0 y 0.22.0 |
| Modelos | Modelos densos y MoE con NVFP4, FP8, AWQ y bf16 |
| Comparación | Ejecuciones emparejadas con y sin CC en el mismo anfitrión, disco y GPU |
En cada comparación se conserva el hardware y se cambia el estado de TDX y CC. Sin embargo, las versiones del software, los modelos y las configuraciones difieren entre experimentos. Comparar los valores de una misma fila resulta más informativo que tratar filas distintas como si fueran intercambiables.
Los autores también explican que las mediciones limpias exigían reiniciar. El estado residual de la GPU produjo una sobrecarga aparente del 16 % en una ejecución; tras un inicio limpio, la misma carga mostró alrededor del 2 %. El estado acumulado puede introducir una diferencia mucho mayor que la sobrecarga que se intenta medir.
El cálculo no es el principal cuello de botella
El hallazgo central es que la multiplicación de matrices, GEMM y el acceso a HBM no fueron las fuentes principales de sobrecarga en esta configuración. El coste apareció sobre todo en las fronteras de comunicación:
- envío de comandos del anfitrión a la GPU;
- transferencias CPU–GPU por PCIe;
- comunicación entre GPU por NVLink cifrado.
La aritmética no se volvió necesariamente más lenta. Lo que se encareció fue entregar los comandos y los datos, y coordinar las GPU.
Primer coste: cada comando pequeño tiene un precio fijo
Cuando el anfitrión lanza un kernel, el comando atraviesa una ruta de control protegida hasta el GPU System Processor, o GSP. El estudio midió unos 12 microsegundos adicionales por envío de kernel en una GPU:
| Operación | CC desactivado | CC activado | Diferencia |
|---|---|---|---|
| Envío de un kernel | 3,45 µs | 15,7 µs | Unos 12 µs |
| Sincronización sin envío | 1,62 µs | 1,67 µs | Casi cero |
Doce microsegundos importan cuando un paso de decodificación contiene decenas o cientos de envíos separados. En el microbenchmark del estudio, cada paso tenía unos 181 kernels. La ejecución inmediata, o eager, volvía a enviarlos en cada paso:
| Modo de ejecución | CC desactivado | CC activado | Relación de tiempos |
|---|---|---|---|
| Eager | 2644 µs por paso | 6358 µs | 2,41× |
| Grafo CUDA completo | 2500 µs | 2589 µs | 1,04× |
Un grafo CUDA registra previamente las operaciones y reproduce el grafo en lugar de enviar cientos de comandos individuales. En este ensayo, una penalización grande en la ruta de control se redujo así a unos pocos puntos porcentuales.
Pero «grafos CUDA activados» no describe lo suficiente. Si el software fragmenta el grafo en cada capa de atención, todavía pueden quedar unos 185 envíos del anfitrión por paso. Importa el número real de envíos, no el nombre del ajuste.
Podemos aproximar este coste mediante:
Cuanto más corto sea el cálculo de un paso y más envíos contenga, mayor será el peso de ese coste fijo.
Segundo coste: PCIe cifrado no es solo ancho de banda
Esta pila transfiere datos entre anfitrión y GPU mediante AES-GCM y búferes intermedios gestionados por el controlador. En transferencias grandes, el coste es aproximadamente proporcional al número de bytes. En las pequeñas, pesan más la preparación criptográfica y el coste de la llamada.
En los ensayos:
- la tasa fue de 7,21 GB/s para 1 MB y de unos 9,4–9,6 GB/s para 16 y 64 MB;
- las transferencias de 64 KB o menos dependían más de una sobrecarga fija de unos 3–6 µs;
- añadir hilos del anfitrión no mejoró la velocidad de cifrado de una sesión de GPU.
La limitación se aprecia al cargar los pesos. Si después los pesos y la caché KV permanecen en la GPU, no tiene por qué repetirse en la ruta crítica de cada token.
El problema más dañino apareció al recuperar desde la GPU el resultado del muestreo al final de cada paso de decodificación. En la pila sin corregir, una pequeña copia del dispositivo al anfitrión que debía solaparse con el cálculo siguiente pasó a ser, en la práctica, síncrona. El planificador se detenía, la GPU esperaba y su utilización caía. La pérdida de rendimiento superaba el tiempo dedicado al cálculo AES.
Aquí aparece el resultado del 30–40 %.
¿Por qué un experimento muestra un 39 % y otro menos del 1 %?
Con SGLang publicado y sin corregir, Qwen3-8B en una B200, con solapamiento activado, produjo:
| Concurrencia | Sin CC, tokens/s | Con CC, tokens/s | Pérdida de rendimiento |
|---|---|---|---|
| 16 | 3828 | 2513 | 34,4 % |
| 32 | 6931 | 4534 | 34,6 % |
| 64 | 11 137 | 6805 | 38,9 % |
Con concurrencia 64, el tiempo por token de salida pasó de 5,48 a 8,28 ms y el tiempo hasta el primer token, de 259 a 409 ms. El «39 %» se refiere a la pérdida de rendimiento; algunas latencias aumentaron todavía más.
La copia D2H dejó de ocultarse tras el cálculo, la planificación se serializó y la utilización de la GPU cayó del 74 al 57 %.
Después de trasladar las copias D2H a un trabajador asíncrono y aplicar correcciones compatibles con CC, otro experimento con una GPU y Qwen2.5-72B-AWQ mostró entre −0,2 y +0,6 % de sobrecarga al variar la concurrencia: prácticamente ruido de medición. Era otro modelo, no una comparación antes y después sobre el mismo modelo. En diez combinaciones de entrada y salida, la mediana fue del 1,2 % y el peor resultado, del 6,5 %.
La pérdida del 30–40 % no es, por tanto, un coste intrínseco del cifrado de la GPU. Surge de la interacción entre el modo confidencial y una pila concreta sin corregir. El resultado cercano a cero también depende del software, el modelo y la forma de la carga.
Tercer coste: NVLink cifrado
Una segunda GPU añade otra ruta: operaciones colectivas como all-reduce y all-to-all deben recorrer NVLink cifrado.
Un microbenchmark con cuatro B200 en un nodo NUMA informó de lo siguiente:
| Métrica | CC activado, GB/s | CC desactivado, GB/s | Reducción calculada |
|---|---|---|---|
| Copy Engine, lectura unidireccional | 8070 | 9170 | 12,0 % |
| Copy Engine, escritura unidireccional | 8278 | 9292 | 10,9 % |
| Lectura mediante SM | 7693 | 9388 | 18,1 % |
| NCCL all-reduce | 156 | 185 | 15,7 % |
| NCCL all-to-all | 130 | 149 | 12,8 % |
Los porcentajes NCCL se calculan a partir de cada fila: las etiquetas «10 %» de la tabla original no coinciden con esos valores. Las filas Copy Engine y SM son métricas del ensayo D2D, no especificaciones de ancho de banda de una conexión NVLink individual. La mediana de latencia de una escritura P2P pequeña también subió de 3,7 a 14,5 µs, casi cuatro veces.
Esto no implica perder un 10–18 % de rendimiento en todo el servicio. El efecto final depende de cuánto tiempo de cada paso se dedica a comunicar las GPU.
Si una operación colectiva ocupa solo el 20 % de la ruta crítica y el cifrado la ralentiza un 10 %, su aportación directa al tiempo total es muy inferior al 10 %. Una carga casi totalmente limitada por la comunicación se acerca más a la penalización de la comunicación pura.
Por eso la diferencia entre PCIe y SXM va más allá del montaje: la ruta y el volumen de comunicación también afectan al coste de la ejecución confidencial.
Dos dimensiones independientes de la sobrecarga
| Dimensión del coste | Comportamiento | Cómo reducirlo |
|---|---|---|
| Operaciones fijas del anfitrión | Se repiten con los envíos, la sincronización y las lecturas de resultados | Grafos CUDA más completos, menos fragmentación, trabajador D2H asíncrono |
| Tráfico NVLink | Varía con el tráfico cifrado entre GPU | Menos operaciones colectivas innecesarias y paralelismo adecuado |
Los lotes grandes reparten el coste fijo de los envíos entre más solicitudes, pero también pueden aumentar el tráfico colectivo. El procesamiento por lotes mejora una dimensión y puede hacer más visible la otra hasta alcanzar una meseta. No existe un tamaño que minimice ambos costes para todas las cargas.
¿En qué condiciones se obtuvo el 1–3 %?
El principal resultado multi-GPU corresponde a MiniMax-M2.7, un modelo MoE con unos 229 000 millones de parámetros totales y 6000 millones activos, en ocho B200.
En el punto de referencia, con 1024 tokens de entrada, 2048 de salida y concurrencia 32:
- TP8 mostró un 2,8 y un 3,6 % de sobrecarga en dos conjuntos de cinco repeticiones;
- TP4 mostró alrededor del 1,5 %;
- al reducir a la mitad el grado de paralelismo tensorial, TP4 conservó el 94 % del rendimiento de TP8.
«Alrededor del 1–3 %» describe un régimen concreto: pila corregida, grafos CUDA por segmentos, solapamiento activado, carga dominada por la decodificación y paralelismo adecuado para el modelo. No es un resultado universal ni se cumple con cualquier configuración del mismo servidor.
| Escenario medido | Sobrecarga informada | Mecanismo principal |
|---|---|---|
| Una GPU, sin solapamiento | Un 2 % aproximadamente | Coste residual de la ruta de comandos |
| Una GPU, solapamiento y pila sin corregir | 34–39 % | Pérdida del solapamiento entre cálculo y copia |
| Una GPU, grafos y pila corregida | Menos del 1 % en el barrido principal | Coste retirado de la ruta crítica |
| MoE con TP8 | Aproximadamente 2,8–3,6 % | All-reduce cifrado |
| MoE con TP4 | Un 1,5 % aproximadamente | Menos tráfico NVLink |
| Qwen3.5 con DP-attention y EP, entrada de 32 768 tokens | Un 2 % aproximadamente | Sin all-reduce en la atención |
| Entrenamiento con ocho GPU | Pasos un 11–24 % más largos | Operaciones colectivas frecuentes |
Las filas de inferencia miden pérdida de rendimiento; las de entrenamiento, aumento de la duración del paso. Los denominadores son distintos. También hay diferencias sustanciales entre los ensayos de entrenamiento:
| Ensayo en ocho GPU | Tiempo por paso sin CC | Tiempo por paso con CC | Aumento |
|---|---|---|---|
| Modelo denso, bf16 y TP8 | 13,95 s | 15,8 s | 13,3 % |
| Modelo denso, delayed FP8 y TP8 | 14,5 s | 18,0 s | 24,1 % |
| MoE ajustado con EP8 | 2,16 s | 2,40 s | 11,1 % |
Los porcentajes se calculan con los tiempos publicados. El experimento FP8 presenta el mayor incremento.
¿Cómo cambia el resultado con la longitud de salida?
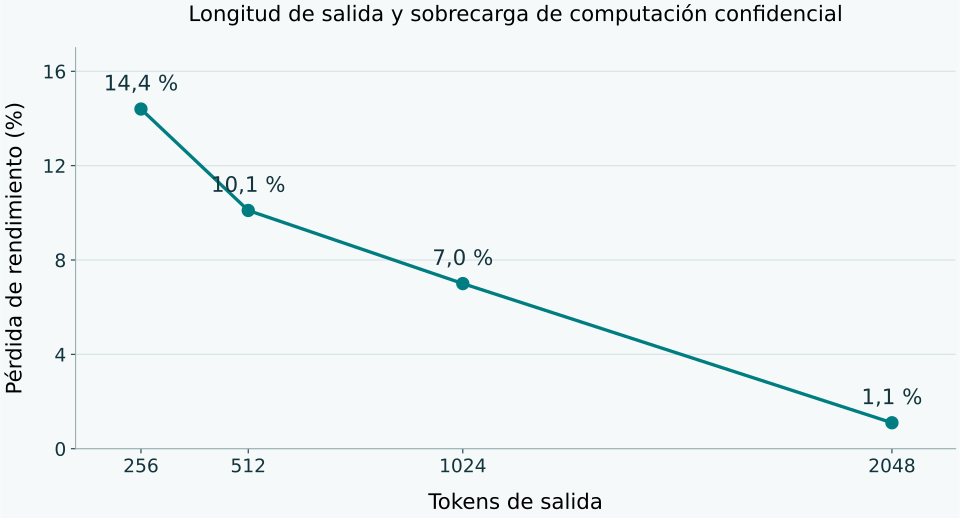
En un barrido de MiniMax-M2.7 con TP8, 1024 tokens de entrada y concurrencia 32, una salida más larga repartió el coste del prefill cifrado entre más pasos de decodificación:
| Tokens de salida | Sin CC, tokens/s | Con CC, tokens/s | Pérdida de rendimiento |
|---|---|---|---|
| 256 | 1701,0 | 1456,0 | 14,4 % |
| 512 | 2300,5 | 2068,4 | 10,1 % |
| 1024 | 2551,4 | 2371,6 | 7,0 % |
| 2048 | 2530,7 | 2504,0 | 1,1 % |
El gráfico utiliza los valores del barrido del artículo. La mayoría de los puntos eran ejecuciones únicas sobre datos aleatorios; los autores indican una variación de unos dos puntos porcentuales. Las mediciones con cinco repeticiones de la misma combinación de 1024 tokens de entrada y 2048 de salida dieron un 2,8–3,6 %, no un 1,1 %. El gráfico sustenta mejor la dirección del cambio que el último decimal de cada punto.
En este ensayo, el procesamiento inicial de la entrada, o prefill, ocupaba una parte mayor del tiempo en respuestas cortas. Al prolongarse la generación de salida, o decode, su contribución relativa disminuía.
Un contexto más largo no siempre reduce la sobrecarga
El efecto depende del paralelismo. En el ensayo de MiniMax-M2.7 con NVFP4, cuatro GPU y TP2/EP4/DP2, ampliar la entrada de 4096 a 32 768 tokens elevó la sobrecarga del 9 al 14,5 %, asociada a más tráfico all-reduce durante el prefill.
En cambio, en Qwen3.5-397B-A17B con FP8, ocho GPU y DP8/EP8, la atención no necesitaba all-reduce entre GPU. En el mismo intervalo de entrada, la sobrecarga cayó del 11,1 al 1,9 %. El cálculo adicional amortizó los costes fijos y la comunicación entre expertos.
Son modelos, formatos numéricos y cantidades de GPU distintos; no se puede atribuir toda la diferencia al paralelismo. Ambos ensayos usaron 256 tokens de salida y concurrencia 32.
Decir que «un contexto largo reduce la sobrecarga de CC» es tan incompleto como afirmar lo contrario. La cuestión es cuánto cálculo adicional y cuánta comunicación cifrada crea ese contexto.
Más paralelismo no siempre es mejor
El paralelismo tensorial intercambia partes de las activaciones entre GPU en cada capa, normalmente mediante all-reduce. En modo confidencial, ese tráfico se cifra. Si el modelo funciona adecuadamente sin TP de ocho vías, distribuirlo entre más participantes puede limitarse a aumentar la comunicación.
En el punto de referencia del estudio, pasar de TP8 a TP4 redujo aproximadamente a la mitad la sobrecarga de CC, hasta el 1,5 %, y conservó el 94 % del rendimiento.
La conclusión no es simplemente utilizar menos GPU. El número de GPU y la anchura de un grupo de paralelismo tensorial son conceptos distintos. Un despliegue mayor puede mantener cada réplica o grupo TP en el tamaño que realmente necesita el modelo.
En modelos MoE, el paralelismo de expertos y de datos también puede requerir menos comunicación síncrona que el tensorial. Hay que probarlo con el modelo, el lote, el contexto y la topología reales.
El software forma parte de la arquitectura de seguridad
La comparación de Ollama, vLLM, SGLang y llama.cpp parte de las necesidades del servicio. Para una ejecución confidencial, el comportamiento de transferencia de una versión concreta del software añade otro criterio. El framework determina cuántas veces se repite un pequeño coste del hardware y en qué punto de la ruta crítica aparece.
El estudio destaca estas medidas:
- utilizar grafos CUDA y reducir su fragmentación;
- trasladar la lectura de tokens a un trabajador asíncrono;
- no solicitar memoria fijada del anfitrión cuando la pila no la admite;
- usar el temporizador global en vez de eventos CUDA en el ajuste automático;
- elegir fusiones que no dependan del multicast bloqueado en modo CC;
- mantener los pesos y la caché KV en la GPU;
- evitar la transferencia continua de pesos, la descarga de expertos a CPU y la descarga de KV en la ruta crítica;
- dimensionar TP según el modelo, no según las GPU disponibles.
Un informe de NVIDIA del 2 de julio de 2026 también destaca el trabajador D2H asíncrono, los temporizadores compatibles con CC y los grafos CUDA por segmentos. Sus pruebas de HGX B300 con Qwen3.5 muestran un impacto aproximado del 1–8 % en distintas cargas. No se deben combinar esos valores con los de B200 ni sustituir unos por otros, pero ambos evidencian el peso de la versión y la configuración del software.
¿Qué no midió el estudio?
Arranque y atestación
No se midieron la creación de la máquina virtual confidencial, la inicialización de GPU, el establecimiento de sesiones seguras, la atestación de CPU/GPU ni la entrega de claves.
La atestación suele preceder a la entrega de secretos y al inicio de la carga, en lugar de repetirse con cada solicitud. Aun así, el arranque puede ser importante en cargas efímeras, escalado automático intenso o servicios sin servidor. El estudio no aporta una cifra para ello.
Comunicación entre anfitriones
Todos los resultados proceden de un anfitrión físico. No se evaluaron RDMA, comunicación de GPU entre servidores, separación de prefill y decode ni transferencia de caché KV entre nodos.
El artículo explica que CC restringe GPUDirect RDMA y los búferes fijados convencionales en la pila probada. Una transferencia puede acabar recorriendo GPU–CPU–CPU–GPU. Es un problema arquitectónico, no una medición cuantitativa de un clúster multinodo.
Garantías de seguridad
El trabajo no auditó ni demostró propiedades de seguridad. Quedaron fuera la resistencia frente a un adversario concreto, el firmware, la cadena de suministro, las claves, la política de atestación y los canales laterales.
Los poderes del administrador, los registros y la información recuperable de las salidas requieren un análisis separado del acceso indirecto a los datos.
Otros equipos
Los resultados corresponden a B200, Intel TDX y versiones específicas de controladores y frameworks. No se trasladan directamente a H100, B300, otras GPU, AMD SEV-SNP, plataformas TDISP/IDE ni generaciones posteriores del software.
¿Qué debe registrar una prueba de aceptación?
Una prueba para adquirir o aceptar infraestructura debería recoger, como mínimo:
| Área | Datos necesarios |
|---|---|
| Hardware | CPU/GPU, cantidad de GPU, topología NUMA y NVLink |
| Seguridad | Tipo de TEE, modo CC, versión de firmware y método de atestación |
| Software | Versiones del controlador, CUDA, NCCL, framework y parches CC |
| Modelo | Versión de pesos, precisión y arquitectura densa o MoE |
| Carga | Distribución de longitudes de entrada/salida, lote y tasa de llegada |
| Paralelismo | TP, PP, DP y EP, con el tamaño de cada grupo |
| Planificación | Grafos CUDA completos o por segmentos, solapamiento y prefill por bloques |
| Memoria | Ubicación de pesos/caché KV y configuración de descarga |
| Resultados | TTFT, TPOT, rendimiento, goodput, errores y utilización |
| Ciclo de vida | Tiempo de arranque, atestación y entrega de claves cuando importe |
| Escala | Uno o varios anfitriones y rutas reales de comunicación |
Ejecute la misma carga con y sin CC sobre idénticos datos y hardware. Repita cada punto y presente la dispersión junto a la media o mediana. Una diferencia del uno o dos por ciento en una sola ejecución puede ser únicamente ruido de medición.
Antes de elegir una configuración
Si la pérdida de rendimiento aumenta del 34 al 39 % con la concurrencia y baja la utilización de GPU, revise primero la lectura de resultados y el planificador. Si crece con la longitud de entrada y el tráfico colectivo, cobran importancia el grado de TP y la comunicación entre GPU. Son problemas que requieren correcciones distintas.
En la configuración de referencia, TP4 conservó cerca del 94 % del rendimiento de TP8 con menos sobrecarga de confidencialidad. Esta comparación resulta más útil que un «coste de CC» universal: ¿qué configuración atiende la carga real con la latencia y la capacidad necesarias?