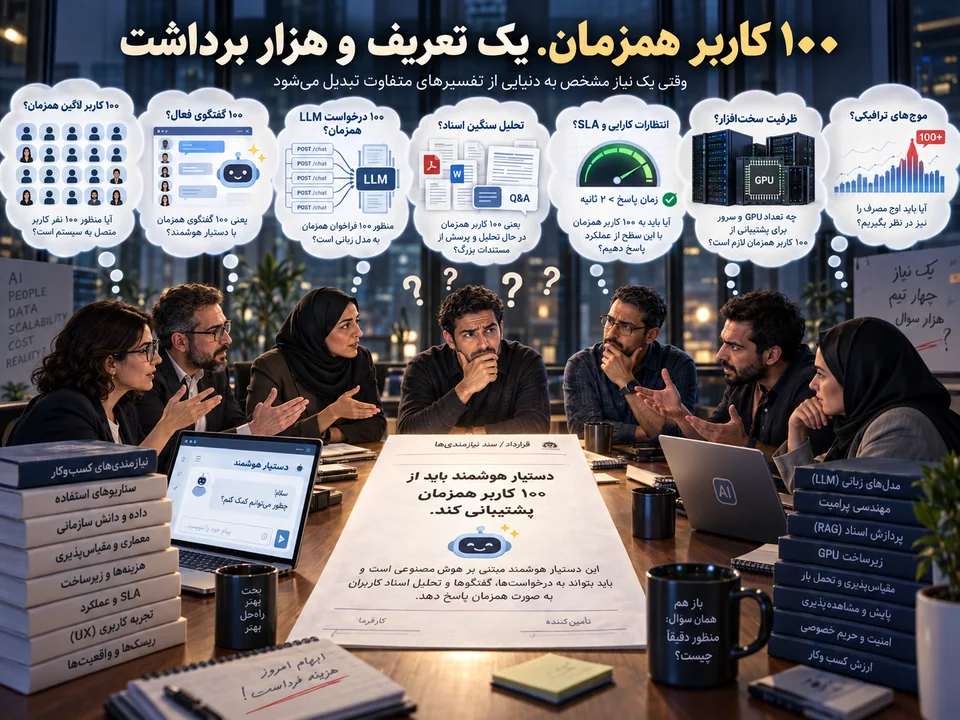
فرض کنید دو شرکت برای خرید یک دستیار هوشمند سازمانی درخواست پیشنهاد دادهاند. هر دو یک شرط ظاهراً یکسان دارند: «سامانه باید از ۱۰۰ کاربر همزمان پشتیبانی کند.»
شرکت اول میخواهد کارکنانش درباره آییننامهها و دستورالعملهای داخلی سؤال کنند و پاسخهای نسبتاً کوتاه بگیرند. شرکت دوم انتظار دارد کارکنانش اسناد چندصدصفحهای را تحلیل کنند، گزارشهای تطبیقی بنویسند و گاهی چند عامل هوشمند را برای انجام یک کار به خدمت بگیرند.
آیا زیرساخت موردنیاز این دو شرکت یکسان است؟
حتی اگر هر دو دقیقاً ۱۰۰ کاربر داشته باشند، ممکن است نیاز پردازشی آنها چندین برابر متفاوت باشد. از سوی دیگر، شاید یک سرور نسبتاً معمولی بتواند به صدها کاربر شرکت اول خدمات قابل قبولی ارائه کند، اما زیر بار فقط چند درخواست سنگین شرکت دوم با تأخیر غیرقابلقبول مواجه شود.
مسئله این است که تعداد کاربران، واحد اندازهگیری ظرفیت پردازشی یک دستیار هوشمند نیست. آنچه ظرفیت را تعیین میکند، ترکیبی از نرخ ورود درخواستها، طول ورودی و خروجی، نوع پردازش، الگوی همزمانی و سطح کیفیت خدمت مورد انتظار است.
این تفاوت در تجربهٔ ترگمان زیر فشار حدود ۳۰۰ درخواست همزمان هم دیده شد: سرویس روی یک RTX 4090 ادامه پیدا کرد، اما صف، کندی پاسخ و لغو بخشی از درخواستها وجود داشت. آن تجربه، مشاهدهٔ ادامهٔ سرویس بود؛ عدد ۳۰۰ بهتنهایی تعهد کیفیت پاسخ برای یک دستیار سازمانی را مشخص نمیکند.
برای روشنشدن موضوع، باید از مفهوم «کاربر همزمان» شروع کنیم و قدمبهقدم به یک مدل محاسباتی برسیم که بتوان با آن درباره انتخاب مدل زبانی، تعداد GPU و هزینه زیرساخت تصمیم گرفت.
۱. صد کاربر، صد درخواست نیست
در یک سامانه سازمانی دستکم چهار عدد متفاوت وجود دارد:
- کاربران متصل (Connected Users): افرادی که وارد سامانه شدهاند و نشست آنها برقرار است.
- کاربران فعال (Active Users): افرادی که در یک بازه زمانی مشخص واقعاً با سامانه کار میکنند.
- درخواستهای در جریان (In-flight Requests): درخواستهایی که ارسال شدهاند، اما هنوز تکمیل نشدهاند؛ چه در صف و چه در حال پردازش.
- درخواستهای در حال استنتاج (Running Inferences): درخواستهایی که واقعاً منابع موتور استنتاج را اشغال کردهاند.
این چهار عدد لزوماً برابر نیستند.
برای مثال، ممکن است ۱۰۰ نفر وارد سامانه شده باشند، ۳۰ نفر در حال مطالعه پاسخ قبلی باشند، ۱۰ نفر در انتظار پاسخ و تنها ۶ درخواست واقعاً در GPU در حال پردازش باشند.
نکته مهمتر اینکه حتی تعداد درخواستهای در حال استنتاج هم بهتنهایی بار پردازشی را مشخص نمیکند. شش درخواست با ورودی ۵۰۰ توکن و خروجی ۱۰۰ توکن، معادل شش درخواست با ورودی ۳۲ هزار توکن و خروجی ۲۰۰۰ توکن نیستند.
بنابراین باید به جای شمارش کاربران، رفتار آنها را مدل کنیم.
۲. اولین محاسبه: هر کاربر چند درخواست تولید میکند؟
فرض کنیم تعداد کاربران فعال و میانگین تعداد درخواستهای هر کاربر در دقیقه باشد.
نرخ ورود درخواستها به سامانه برابر است با:
که در آن بر حسب درخواست در ثانیه است.
برای ۱۰۰ کاربر، سه الگوی استفاده را در نظر بگیریم:
| الگوی استفاده | درخواست هر کاربر در دقیقه | نرخ کل درخواست |
|---|---|---|
| سبک | ۰٫۱ | ۰٫۱۶۷ درخواست/ثانیه |
| متوسط | ۰٫۵ | ۰٫۸۳۳ درخواست/ثانیه |
| سنگین | ۲ | ۳٫۳۳۳ درخواست/ثانیه |
در سناریوی اول، هر کاربر بهطور متوسط هر ده دقیقه یک درخواست میفرستد. در سناریوی سوم، هر کاربر هر سی ثانیه یک درخواست ارسال میکند.
هر دو سامانه ۱۰۰ کاربر دارند، اما نرخ ورود درخواست در دومی ۲۰ برابر اولی است.
البته این محاسبه هنوز یک فرض سادهکننده دارد: ورود درخواستها را با میانگین توصیف میکند. در محیط واقعی، درخواستها الزاماً با فاصلههای منظم وارد نمیشوند.
ممکن است در یک دقیقه فقط دو درخواست دریافت شود و در چند ثانیه بعدی، ۲۰ درخواست تقریباً همزمان برسد. به همین دلیل، علاوه بر نرخ متوسط، باید رفتار بار در ساعات اوج و شدت جهشهای کوتاهمدت را نیز اندازه گرفت.
۳. دومین محاسبه: هر درخواست چقدر کار دارد؟
در مدلهای زبانی، یک درخواست معمولاً دو بخش اصلی دارد:
Prefill: پردازش توکنهای ورودی، شامل سؤال کاربر، دستورالعملهای سامانه، تاریخچه مکالمه و اسناد بازیابیشده.
Decode: تولید توکنهای خروجی، معمولاً بهصورت تدریجی.
این دو مرحله رفتار محاسباتی یکسانی ندارند. Prefill در بسیاری از شرایط بیشتر به ظرفیت محاسبات موازی وابسته است، درحالیکه Decode، بهویژه در Batchهای کوچک، میتواند به پهنایباند حافظه حساس باشد.
برای مطالعه عمیقتر تفاوت این دو مرحله، راهنمای انتخاب GPU برای هوش مصنوعی و یادداشت «چرا سریعترین GPU لزوماً سریعترین پاسخ را نمیدهد؟» را میتوان در کنار این یادداشت مطالعه کرد؛ دومی فرق نرخ کل توکن با زمان آغاز و تکمیل پاسخ هر کاربر را باز میکند.
فرض کنیم سه نوع درخواست در سامانه داریم:
| نوع درخواست | توکن ورودی | توکن خروجی |
|---|---|---|
| پرسش ساده | ۱٬۰۰۰ | ۱۵۰ |
| پرسش مبتنی بر RAG | ۸٬۰۰۰ | ۵۰۰ |
| تحلیل چندسندی | ۳۲٬۰۰۰ | ۲٬۰۰۰ |
اکنون فرض کنیم ترکیب درخواستها به ترتیب ۷۰، ۲۵ و ۵ درصد باشد.
میانگین توکن ورودی هر درخواست:
میانگین توکن خروجی:
اگر نرخ ورود درخواستها یک درخواست در ثانیه باشد، تقاضای متوسط ورودی و خروجی بهترتیب چنین خواهد بود:
این اعداد، نرخ تقاضای توکن هستند، نه توان لازم GPU بر حسب FLOPS و نه بنچمارک قابل تعهد یک سرور.
بهویژه نباید ۴۳۰۰ توکن ورودی را با ۳۳۰ توکن خروجی جمع کنیم و نتیجه بگیریم سامانه به ظرفیت ۴۶۳۰ توکن بر ثانیه نیاز دارد. هزینه محاسباتی این دو مرحله متفاوت است و رفتار آنها با Batch و طول زمینه تغییر میکند.
سهم هر گروه از تقاضای توکن در همین مثال، با نرخ یک درخواست در ثانیه:
| گروه | سهم درخواستها | سهم ورودی، توکن/ثانیه | سهم خروجی، توکن/ثانیه |
|---|---|---|---|
| ساده | ۷۰٪ | ۷۰۰ | ۱۰۵ |
| RAG | ۲۵٪ | ۲٬۰۰۰ | ۱۲۵ |
| تحلیلی | ۵٪ | ۱٬۶۰۰ | ۱۰۰ |
| مجموع | ۱۰۰٪ | ۴٬۳۰۰ | ۳۳۰ |
اینها مقادیر تقاضا در مثال آموزشیاند؛ ظرفیت اندازهگیریشدهٔ GPU نیستند.
یک نکته جالب در همین مثال پنهان است: فقط ۵ درصد درخواستها تحلیلی هستند، اما حدود ۳۷ درصد توکنهای ورودی را تولید میکنند.
بنابراین اقلیتی از درخواستهای سنگین میتوانند سهم بزرگی از ظرفیت پردازش ورودی را مصرف کنند.
۴. سومین محاسبه: چند درخواست واقعاً همزمان خواهند بود؟
اینجا میتوان از یکی از روابط شناختهشده نظریه صف، یعنی قانون لیتل (Little’s Law) استفاده کرد:
که در آن:
- : متوسط تعداد درخواستهای درون سامانه
- : نرخ متوسط ورود و تکمیل درخواست در وضعیت پایدار
- : متوسط زمان حضور درخواست در سامانه
فرض کنیم نرخ ورود یک درخواست در ثانیه و میانگین زمان تکمیل پاسخ ۸ ثانیه باشد:
یعنی بهطور متوسط هشت درخواست در سامانه حضور دارند.
اگر با افزایش بار، زمان پاسخ به ۲۰ ثانیه برسد:
اکنون ۲۰ درخواست در سامانه حضور دارند، بدون آنکه تعداد کاربران یا نرخ ورود درخواستها تغییر کرده باشد.
اما باید در تفسیر این رابطه دقت کرد. این ۲۰ درخواست لزوماً همگی در GPU در حال پردازش نیستند. برخی ممکن است در صف باشند، برخی در مرحله بازیابی اسناد و برخی در حال تولید متن.
قانون لیتل ظرفیت GPU را محاسبه نمیکند؛ رابطهای میان نرخ عبور، تعداد درخواستهای موجود و زمان حضور آنها برقرار میکند. همچنین این رابطه در وضعیت پایدار معنا دارد و بهتنهایی رفتار جهشهای ناگهانی بار را پیشبینی نمیکند.
۵. چهارمین محاسبه: صف چگونه یک سامانه سریع را کند میکند؟
برای فهم اولیه، یک مدل صف ساده با نرخ ورود و ظرفیت خدمت در نظر بگیریم.
ضریب بهرهبرداری:
اگر ظرفیت مؤثر سامانه ۲ درخواست در ثانیه و نرخ ورود ۱ درخواست در ثانیه باشد:
اما اگر نرخ ورود به ۱٫۹ درخواست در ثانیه برسد:
سامانه هنوز از نظر متوسط، ظرفیت بیشتری از نرخ ورود دارد؛ بااینحال فاصله بسیار کمی تا اشباع باقی مانده است.
در مدل ایدهآل M/M/1، میانگین زمان حضور درخواست در سامانه از رابطه زیر به دست میآید:
برای درخواست در ثانیه، همین مدل نظری چنین رفتاری دارد:
| بهرهبرداری | نرخ ورود، درخواست/ثانیه | میانگین زمان حضور، ثانیه |
|---|---|---|
| ۲۵٪ | ۰٫۵ | ۰٫۶۷ |
| ۵۰٪ | ۱ | ۱ |
| ۷۰٪ | ۱٫۴ | ۱٫۶۷ |
| ۸۰٪ | ۱٫۶ | ۲٫۵ |
| ۹۰٪ | ۱٫۸ | ۵ |
| ۹۵٪ | ۱٫۹ | ۱۰ |
| ۹۸٪ | ۱٫۹۶ | ۲۵ |
| ۹۹٪ | ۱٫۹۸ | ۵۰ |
رابطه برای و فرضهای M/M/1 است؛ برای vLLM باید تأخیر واقعی را زیر بار اندازه گرفت.
در این مدل، افزایش بهرهبرداری از ۵۰ به ۹۵ درصد، زمان متوسط حضور را از یک ثانیه به ده ثانیه افزایش میدهد.
البته موتور استنتاج LLM یک صف M/M/1 واقعی نیست. Continuous Batching، زمانبندی درخواستها، طول نامتوازن توکنها و مدیریت KV Cache، همگی باعث میشوند ظرفیت خدمت با بار تغییر کند.
ارزش این مثال در پیشبینی عدد واقعی نیست؛ در نشاندادن یک اصل است: بیشینهکردن استفاده از GPU لزوماً به معنی ارائه بهترین خدمت به کاربران نیست.
به همین دلیل، در طراحی یک دستیار سازمانی نباید هدف صرفاً رساندن GPU به بهرهبرداری ۱۰۰ درصد باشد. باید نقطهای را پیدا کرد که افزایش بار هنوز به نقض زمان پاسخ مورد انتظار منجر نشده است.
۶. پنجمین محاسبه: آیا حافظه GPU برای این همزمانی کافی است؟
تا اینجا درباره سرعت صحبت کردیم. اما ممکن است پیش از آنکه GPU از نظر توان محاسباتی اشباع شود، حافظه آن به پایان برسد.
حافظه موردنیاز اجرای یک مدل را میتوان بهصورت تقریبی چنین نوشت:
برای یک مدل Dense با پارامتر و دقت ذخیرهسازی بیت:
برای نمونه، یک مدل ۸ میلیاردپارامتری با وزنهای BF16 حدود ۱۶ گیگابایت حافظه خام نیاز دارد. اگر روی یک RTX 4090 با ۲۴ گیگابایت VRAM اجرا شود، نمیتوان نتیجه گرفت که تمام ۸ گیگابایت باقیمانده برای درخواستهای کاربران قابل استفاده است.
بخشی از حافظه در اختیار Runtime، بافرها و ساختارهای اجرایی قرار میگیرد. همچنین ۱۶ میلیارد بایت وزن خام، حدود ۱۴٫۹ GiB است؛ بهتر است در محاسبه نهایی، اندازهٔ وزن، کش و حافظهٔ آزاد دستگاه همگی به یک واحد تبدیل شوند. برای وزن کمدقت هم «چهاربیتیکردن مدل چه چیزی را ارزان میکند و چه چیزی را تغییر میدهد؟» را ببینید: کوچکشدن وزن، KV Cache و سربار خدمت را به همان نسبت کوچک نمیکند.
حافظه KV Cache
در یک ترنسفورمر متعارف، حافظه کش هر توکن را میتوان تقریباً از رابطه زیر محاسبه کرد:
در این رابطه تعداد بایت هر عنصر کش است.
برای یک مدل فرضی با ۳۲ لایه، ۸ سر KV، اندازه سر ۱۲۸ و کش BF16:
یعنی حدود ۱۲۸ کیبیبایت برای هر توکن زنده.
برای ۳۰ درخواست و ۱۹٬۴۵۶ توکن زنده در هر درخواست، کش نظری به ۷۱٫۲۵ GiB میرسد؛ وزن مدل و سربار موتور هنوز در این عدد نیستند. تغییر همین دو عدد نشان میدهد چرا طول زمینه و همزمانی باید با هم سنجیده شوند.
ابزار تعاملی: مدل، GPU و تعداد درخواست را کنار هم ببینیم
در ابزار زیر، مدل آموزشی همین معماری را دارد. برای بستههای واقعی، اندازهٔ فایل وزن و هندسهٔ مدل از دادههای جدول LLM خوانده میشود. تعداد GPU و چیدمان مدل را انتخاب کنید و دو اسلایدر را حرکت بدهید. اگر هنوز سختافزار مشخصی ندارید، ابزار از فهرست GPUهای سایت چند نامزد پیشنهاد میدهد.
از تعداد کاربر تا بودجهٔ حافظه
این بار روی کدام GPU جا میگیرد؟
مدل و بار را انتخاب کنید. اگر GPU مشخص نکردهاید، چند نامزد برای آزمون پیشنهاد میشود. «جا دارد» در این ابزار، نتیجهٔ برآورد حافظه است؛ تعهد سرعت و کیفیت خدمت به آزمون نیاز دارد.
فرضهای حافظه و فضای آزاد واقعی
مدل آموزشی: ۸ میلیارد پارامتر، وزن خام BF16، ۳۲ لایه، ۸ سر KV و اندازهٔ سر ۱۲۸. هندسهٔ فعلی: ۳۲ لایه، ۸ سر KV، اندازهٔ سر ۱۲۸.
ذخیرهٔ پیشفرض ۲ GiB، فرض برنامهریزی جدول است؛ مقدار اندازهگیریشده یا سقف سربار نیست. کوانتیدهبودن وزن به معنی KV کمدقت نیست؛ پشتیبانی موتور و اثر دقت کش را جدا بررسی کنید. این تخمین برای توجه کامل است و صرفهجویی Prefix Cache، توجه پنجرهای، MLA یا معماری هیبریدی را فرض نمیکند.
اولین نامزد برای مقایسه: ۱ × GeForce RTX 5090
در برآورد حافظه جا دارد
- وزن ۱۴٫۹ GiB
- KV ۸ GiB
- ذخیره و اجزای دیگر ۲ GiB
برای توزیع متوازن، بیشترین سهم هر GPU برابر ۸ درخواست فرض شده است. وزن مدل در هر GPU دوباره بارگذاری میشود؛ صف و توزیع نامتوازن میتوانند این برآورد را تغییر دهند.
کلاس اسمی حافظهٔ جدول برای غربال اولیه، بهصورت بودجهٔ GiB استفاده شده است؛ برای استقرار، عدد واقعی حافظهٔ آزاد دستگاه را وارد کنید. سقف نظری بالا، ظرفیت پاسخگویی با تأخیر قابل قبول نیست.
PCIe، وابسته به سازنده · اکتیو · PCIe 5.0
مشخصات سازنده ↗پیشنهاد GPU برای آزمون
نامزدها از فهرست فعلی GPU سایت میآیند و با کمترین تعداد دستگاه و سپس ظرفیت حافظه مرتب شدهاند. قیمت، سرعت و سازگاری این بسته با هر موتور هنوز باید بررسی شود. اگر افزایش تعداد لازم باشد، همان تعداد پیشنهادی کنار نام کارت آمده است.
- ۱ × GeForce RTX 5090۳۲ GB در هر GPU · حاشیهٔ برآوردی ۷٫۱ GiB
- ۱ × RTX 6000 Ada۴۸ GB در هر GPU · حاشیهٔ برآوردی ۲۳٫۱ GiB
- ۲ × GeForce RTX 4090 D۲۴ GB در هر GPU · حاشیهٔ برآوردی ۳٫۱ GiB
نسخههای اعلامشده، بردهای غیررسمی، حافظهٔ یکپارچهٔ سامانهها و ظرفیت تجمیعی چند تراشه در پیشنهادها نیستند. برای AMD و Intel، پشتیبانی بسته، کرنل و موتور اجرا را روی همان مدل و سیستمعامل بررسی کنید.
بار کاربران و تقاضای توکن را هم ببینید
- درخواست کاربر در ثانیه
- ۰٫۸۳۳
- فراخوانی مدل در ثانیه
- ۰٫۸۳۳
- تقاضای ورودی، توکن/ثانیه
- ۳٬۵۸۳٫۳۳
- تقاضای خروجی، توکن/ثانیه
- ۲۷۵
- درخواست کاربر در جریان؛ قانون لیتل
- ۶٫۶۷
قانون لیتل، در وضعیت پایدار، صف و همهٔ مراحل گردشکار را هم میشمارد؛ این عدد خودکار به اسلایدر درخواستهای در حال استنتاج منتقل نمیشود. ورودی و خروجی را جدا سنجیدهایم و زمان پاسخ فرضشده، پیشبینی ابزار نیست.
نسبت تقاضا به ظرفیت اندازهگیریشده: Prefill نیازمند آزمون; Decode نیازمند آزمون.
این دو نسبت فقط غربال اولیهاند؛ تداخل مراحل، P95، جهش بار و Goodput باید زیر بار ترکیبی آزموده شوند. ظرفیت اندازهگیریشدهٔ کل همین چیدمان را وارد کنید؛ ابزار سرعت را با تعداد GPU ضرب نمیکند. پس از تغییر مدل، چیدمان یا طول درخواست، عددهای آزمون پاک میشوند تا نتیجهٔ همان حالت را وارد کنید.
در حالت چند نمونهٔ مستقل، هر GPU وزن کامل مدل را نگه میدارد و درخواستها میان نمونهها تقسیم میشوند. در حالت تقسیم مدل، ابزار فقط بودجهٔ تقسیم یکنواخت را نشان میدهد؛ حافظهٔ هر دستگاه و پشتیبانی موتور و ارتباطات باید جدا بررسی شوند. تفاوت مسیرهای سختافزاری در «PCIe یا SXM؛ تفاوت رابطها در زیرساخت هوش مصنوعی» توضیح داده شده است.
این مثال به معماری فرضی مشخصشده وابسته است. مدلهایی با GQA متفاوت، MLA یا توجه هیبریدی، الگوی مصرف حافظه متفاوتی دارند. همچنین Paged KV Cache و Prefix Caching میتوانند تخصیص و اشتراک حافظه را تغییر دهند.
نتیجه مهم این است که همزمانی و طول زمینه با یکدیگر رقابت میکنند. ممکن است یک پیکربندی بتواند تعداد زیادی درخواست کوتاه را پردازش کند، اما با چند درخواست دارای زمینه ۳۲K به محدودیت حافظه برسد.
۷. ششمین محاسبه: یک کاربر میتواند چندین درخواست تولید کند
در دستیارهای مبتنی بر عامل (Agentic)، رابطه یک کاربر با یک درخواست حتی پیچیدهتر میشود.
فرض کنیم کاربر از دستیار بخواهد پنج قرارداد را بررسی کند، بندهای متعارض را استخراج کند و گزارش نهایی بنویسد. سامانه ممکن است برای این کار چندین فراخوانی مدل انجام دهد؛ بعضی متوالی و بعضی موازی.
اگر هر درخواست کاربر بهطور متوسط فراخوانی مدل ایجاد کند:
برای نرخ یک درخواست کاربر در ثانیه و متوسط چهار فراخوانی مدل:
اما حتی این عدد هم برای ظرفیتسنجی کافی نیست. چهار فراخوانی ممکن است طولهای بسیار متفاوتی داشته باشند و بعضی خروجی یک مرحله را به ورودی مرحله بعد منتقل کنند.
در نتیجه، در سامانههای Agentic باید علاوه بر تعداد فراخوانیها، گراف اجرای کار، وابستگی مراحل، امکان موازیسازی و حجم توکن هر مرحله را نیز در نظر گرفت.
برای مثال، یک گردشکار تحلیل قرارداد میتواند این مراحل را داشته باشد:
| مرحله | وابستگی و الگوی احتمالی اجرا |
|---|---|
| استخراج اطلاعات هر قرارداد | چند فراخوانی؛ امکان اجرای موازی روی اسناد مستقل |
| بررسی تعارضها | متکی به اطلاعات استخراجشده |
| بازیابی مقررات | بسته به طراحی، همزمان با استخراج یا پس از مشخصشدن مسئله |
| ترکیب نتایج و گزارش نهایی | متکی به خروجی مراحل قبلی |
هر مرحله ممکن است خودش چند فراخوانی داشته باشد؛ این جدول یک مثال طراحی است، نه شمار ثابت فراخوانیها.
به همین دلیل، ظرفیت ۱۰۰ کاربر برای یک چتبات پرسشوپاسخ را نمیتوان مستقیماً به یک دستیار عاملمحور تعمیم داد.
۸. پس ظرفیت واقعی را چگونه محاسبه کنیم؟
برای یک برآورد اولیه، میتوان از مفهوم «تقاضای خدمت» استفاده کرد.
فرض کنیم برای هر کلاس درخواست ، سهم درخواستها و زمان اشغال معادل منابع در یک پیکربندی مرجع باشد.
تقاضای متوسط خدمت:
در یک مدل ساده تکمنبعی با ظرفیت خدمت ثابت:
اما این مدل برای استنتاج LLM فقط یک تقریب است؛ زیرا Batch کردن درخواستها میتواند هزینه خدمت هر درخواست را تغییر دهد و Prefill و Decode نیز منابع را به شیوههای متفاوت مصرف میکنند.
برای یک برآورد فنی دقیقتر، میتوان ظرفیت را در چند بُعد جداگانه ارزیابی کرد:
در اینجا و ظرفیتهای اندازهگیریشده تحت بار مرجع هستند، نه اعداد خام FLOPS یا پهنایباند حافظه. این نسبتها یک تقریب غربالگریاند و اثر تداخل مراحل را بهطور کامل مدل نمیکنند.
همچنین باید منابع بازیابی اسناد، بازرتبهبندی، CPU، RAM، شبکه و ذخیرهسازی را جداگانه سنجید. در یادداشت انتخاب مدل زبانی، embedding و reranker برای دستیار اسناد مسئولیت این سه جزء جدا شده است؛ اجرای آنها روی یک GPU، بودجهٔ حافظه و زمان خدمت مشترک میخواهد. ممکن است موتور LLM هنوز ظرفیت آزاد داشته باشد، اما تأخیر بازیابی اسناد کل تجربه کاربر را مختل کند.
۹. معیار نهایی، تعداد توکن نیست؛ تعداد پاسخ قابل قبول است
فرض کنیم دو پیکربندی در یک آزمون، هرکدام ۱۰۰۰ درخواست را در ده دقیقه تکمیل کنند.
در پیکربندی اول، ۹۷۰ درخواست شرایط زمان پاسخ و کیفیت تعیینشده را رعایت کردهاند. در دومی فقط ۷۰۰ درخواست در محدوده مورد قبول بودهاند.
Throughput هر دو یکسان است:
اما Goodput آنها متفاوت است:
از منظر سازمانی، پیکربندی اول خدمت مؤثرتری ارائه کرده است، حتی اگر هر دو در بنچمارک خام تعداد یکسانی درخواست تکمیل کرده باشند.
در مقایسهٔ Ollama، vLLM، SGLang و llama.cpp هم انتخاب موتور به نوع خدمت و شرایط اجرا وابسته است. برای ثبت معیارها میتوان از GenAI-Perf و تعریف دقیق ابزار آزمون شروع کرد.
برای همین باید معیارهای زیر را در آزمون ظرفیت ثبت کرد: زمان نخستین توکن (TTFT)، فاصله تولید توکنها (TPOT/ITL)، زمان تکمیل پاسخ (E2E)، صدکهای P95 و P99، نرخ خطا و Goodput.
تفاوت این معیارها بهخصوص وقتی مهم میشود که در قرارداد نوشته شده باشد «زمان پاسخ کمتر از سه ثانیه». سه ثانیه برای نمایش اولین توکن با سه ثانیه برای تولید یک پاسخ ۵۰۰ توکنی کاملاً متفاوت است.
۱۰. از عدد ۱۰۰ به یک آزمون قابل دفاع برسیم
برای طراحی آزمون ظرفیت، پیشنهاد میکنم بهجای یک سناریو، یک ماتریس بار تعریف شود.
| سناریو | کاربران فعال | الگوی بار | هدف آزمون |
|---|---|---|---|
| استفاده معمول | ۱۰۰ | پرسشهای کوتاه و RAG | TTFT و Goodput |
| ساعت اوج | ۱۰۰ | ورود جهشی درخواستها | P95 و رشد صف |
| تحلیل سنگین | ۲۵ | زمینه بلند و خروجی مفصل | حافظه و E2E |
| عاملمحور | ۲۵ | فراخوانیهای چندمرحلهای | ظرفیت کل گردشکار |
| بار ترکیبی | ۱۰۰ | ترکیب همه گروهها | پایداری و SLO |
این جدول یک طرح آزمایشی پیشنهادی است، نه مشخصات واقعی یک محصول.
برای هر ردیف باید نرخ ورود، توزیع طول ورودی و خروجی، مدل و نسخه آن، موتور استنتاج، وضعیت کش، محدودیت تأخیر و مدت آزمون مشخص شود.
سپس نرخ ورود را مرحلهبهمرحله افزایش میدهیم تا یکی از محدودیتهای تعریفشده نقض شود. ثبت موفقیت درخواستها نیز باید به معنی رعایت معیار کیفیت و زمان باشد؛ تکمیل یک پاسخ نادرست یا پاسخ دیررس، Goodput محسوب نمیشود.
در سرویس چندکاربره، آزمون ظرفیت باید با آزمون جداسازی نشست همراه باشد. همانطور که در بخش جداسازی نشست و cache آمده است، درستبودن صف و throughput، جداسازی زمینهٔ کاربران را اثبات نمیکند. با شناسه یا canary متفاوت برای هر کاربر، و کش فعال در پیکربندی هدف، هر مشاهدهٔ محتوای کاربر دیگر باید آزمون را متوقف کند.
به این ترتیب میتوان ظرفیت عملیاتی را چنین تعریف کرد:
یعنی بیشترین نرخ ورود پایدار که در آن همه الزامات کیفیت خدمت برقرار بمانند؛ البته برای ترکیب بار، پیکربندی و شرایط آزمون مشخص.
این تعریف بسیار دقیقتر از عبارت «پشتیبانی از ۱۰۰ کاربر همزمان» است.
۱۱. آیا برای ۱۰۰ کاربر به H100 نیاز داریم؟
با اطلاعاتی که تا اینجا داریم، پاسخ قابل دفاعی وجود ندارد.
ممکن است یک مدل کوچک کوانتیده روی یک GPU میانرده برای الگوی استفاده سبک کافی باشد. ممکن است برای یک مدل بزرگ با زمینه طولانی به چند شتابدهنده نیاز داشته باشیم. حتی ممکن است بهترین طراحی، تقسیم بار میان یک مدل کوچک برای پرسشهای معمول و یک مدل بزرگتر برای درخواستهای تحلیلی باشد.
بنابراین انتخاب سختافزار باید پس از تعریف بار کاری انجام شود، نه پیش از آن.
این موضوع با بحث مطرحشده در راهنمای انتخاب مدلهای زبانی نیز ارتباط مستقیم دارد: مدل بزرگتر الزاماً انتخاب مناسبتری نیست. مدل مناسب باید هم کیفیت لازم را ارائه کند و هم در الگوی واقعی استفاده، از نظر سرعت، حافظه و هزینه قابل بهرهبرداری باشد.
منطق انتخاب مدل کوچک برای کار معمول و مدل قویتر برای تحلیل، در «برای هر کاربرد واقعاً چه اندازه مدلی لازم داریم؟» توضیح داده شده است. ابزار این صفحه فقط بخش حافظهٔ چنین انتخابی را غربال میکند؛ کیفیت فارسی و کیفیت انجام کار باید روی نمونههای سازمان مقایسه شوند.
همچنین میتوان هزینه را به جای قیمت خام GPU، بر اساس پاسخ موفق محاسبه کرد:
در این رابطه هزینه ساعتی باید سهم استهلاک، برق، خنکسازی، نگهداری و زیرساخت را شامل شود.
این معیار کمک میکند پیکربندیهایی را مقایسه کنیم که شاید قیمت خرید و توان اسمی بسیار متفاوتی داشته باشند، اما از منظر پاسخ قابل قبول، ارزش اقتصادی نزدیک یا حتی معکوسی ایجاد کنند.
در قرارداد به جای ۱۰۰ کاربر، چه چیزی را باید تعهد کنیم؟
عبارت «پشتیبانی از ۱۰۰ کاربر همزمان» بهتنهایی نه برای انتخاب GPU کافی است، نه برای برآورد هزینه و نه برای پذیرش فنی یک دستیار هوشمند.
یک تعهد مهندسی باید روشن کند که ۱۰۰ کاربر با چه الگوی مراجعهای، چه ترکیبی از درخواستها، چه طول زمینه و خروجی، روی کدام مدل و با چه محدودیت زمانی و کیفی قرار است خدمت دریافت کنند. این مشخصات باید همراه نسخهٔ مدل، موتور و تنظیمات آزمون، در معیار پذیرش ثبت شوند؛ پیوند همین موضوع با تحویلدادنیهای پروژه در «قرارداد هوش مصنوعی؛ دقیقاً چه چیزی را باید تحویل بگیریم؟» آمده است.
شاید مهمترین تغییر نگاه این باشد که به جای پرسیدن «این سرور چند کاربر را پشتیبانی میکند؟» بپرسیم:
این سامانه در چه شرایطی، چند درخواست مفید را با چه کیفیتی و با چه هزینهای تکمیل میکند؟
این پرسش هم برای خریدار یک دستیار هوشمند ضروری است و هم برای شرکتی که میخواهد ظرفیت محصولش را به مشتری تعهد کند.
منابع فنی برای آزمون و پیادهسازی
- معیارهای GenAI-Perf در مستندات NVIDIA: تعریف زمان آغاز و تکمیل پاسخ، فاصلهٔ توکنها و نرخ درخواست.
- تنظیم و بهینهسازی vLLM: اثر کمبود KV، توقف و محاسبهٔ مجدد درخواست، پردازش ورودی مرحلهای و راهبردهای تقسیم مدل.
- راهبردهای موازیسازی vLLM: تفاوت تقسیم مدل با تکثیر مدل برای پردازش دستههای مستقل.
اعداد این یادداشت مثالهای محاسباتیاند. برای تعهد به مشتری، همان مدل، بستهٔ وزن، موتور، سختافزار و ترکیب بار باید آزموده شوند.