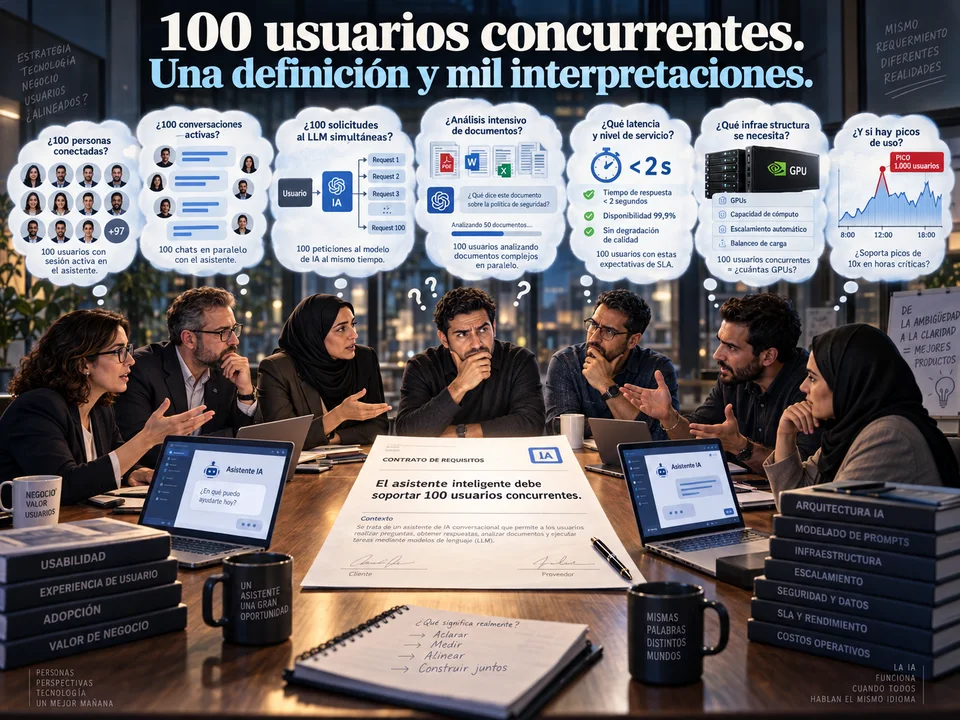
Imaginemos dos empresas que solicitan propuestas para un asistente de IA corporativo. Ambas plantean un requisito aparentemente idéntico: «El sistema debe admitir 100 usuarios simultáneos».
La primera quiere que sus empleados consulten normas y procedimientos internos y reciban respuestas relativamente breves. La segunda espera que analicen documentos de cientos de páginas, redacten informes comparativos y, en ocasiones, utilicen varios agentes para completar una tarea.
¿Necesitan la misma infraestructura?
Incluso con exactamente 100 usuarios cada una, sus necesidades de procesamiento pueden diferir varias veces. Un servidor relativamente corriente podría atender a cientos de personas de la primera empresa y, sin embargo, producir retrasos inaceptables con unas pocas solicitudes pesadas de la segunda.
El número de usuarios no es una unidad de capacidad de procesamiento. La capacidad depende de la tasa de llegada de solicitudes, la longitud de entrada y salida, el tipo de procesamiento, el patrón de concurrencia y el nivel de servicio esperado.
El informe en persa sobre Targoman bajo unas 300 solicitudes simultáneas ilustra esta diferencia. El servicio continuó en una RTX 4090, pero hubo colas, respuestas más lentas y cancelaciones. Lo observado fue la continuidad del servicio; el número 300 no establece por sí solo un compromiso de calidad para un asistente corporativo.
Para elegir un modelo de lenguaje, el número de GPU y el presupuesto de infraestructura, conviene aclarar primero qué significa «usuarios simultáneos» y construir el cálculo paso a paso.
1. Cien usuarios no son cien solicitudes
En un sistema corporativo hay al menos cuatro cifras distintas:
- Usuarios conectados: personas con una sesión abierta.
- Usuarios activos: personas que utilizan realmente el sistema durante un intervalo definido.
- Solicitudes en curso: solicitudes enviadas que aún no han terminado, tanto en cola como en procesamiento.
- Inferencias en ejecución: solicitudes que ocupan recursos del motor de inferencia.
Estas cifras no tienen por qué coincidir. Puede haber 100 personas conectadas, 30 leyendo una respuesta anterior, diez esperando y solo seis solicitudes ejecutándose en la GPU.
Ni siquiera el número de inferencias define toda la carga. Seis solicitudes con 500 tokens de entrada y 100 de salida no equivalen a seis con 32.000 de entrada y 2.000 de salida.
Hay que modelar el comportamiento de los usuarios, además de contarlos.
2. Primer cálculo: ¿con qué frecuencia solicita algo cada usuario?
Sea el número de usuarios activos y la media de solicitudes por usuario y minuto. La tasa de llegada es:
se expresa en solicitudes por segundo. Para 100 usuarios:
| Patrón de uso | Solicitudes por usuario y minuto | Tasa total de llegada |
|---|---|---|
| Ligero | 0,1 | 0,167 solicitudes/s |
| Moderado | 0,5 | 0,833 solicitudes/s |
| Intenso | 2 | 3,333 solicitudes/s |
En el primer caso, cada usuario envía una solicitud cada diez minutos de media. En el tercero, cada 30 segundos. Los dos sistemas tienen 100 usuarios, pero sus tasas de llegada difieren por un factor de 20.
Este cálculo aún simplifica las llegadas mediante una media. En la práctica no llegan necesariamente a intervalos regulares: pueden recibirse dos en un minuto y, poco después, 20 casi a la vez. También hay que medir las horas punta y las ráfagas breves de carga.
3. Segundo cálculo: ¿cuánto trabajo contiene cada solicitud?
Una solicitud a un modelo de lenguaje suele tener dos etapas:
Prefill: procesamiento de los tokens de entrada, incluidos la pregunta, las instrucciones del sistema, el historial y los documentos recuperados.
Decode: generación de los tokens de salida, normalmente de forma progresiva.
No se comportan igual. El prefill suele depender más de la capacidad de cómputo paralelo; el decode, especialmente con lotes pequeños, puede ser sensible al ancho de banda de memoria.
La guía de selección de GPU y el artículo sobre por qué la GPU más rápida no siempre entrega la respuesta más rápida desarrollan esta diferencia. El segundo distingue la tasa total de tokens del tiempo de inicio y finalización de la respuesta. Aquí comenzamos por la demanda de los usuarios.
Supongamos tres tipos de solicitud:
| Tipo | Tokens de entrada | Tokens de salida |
|---|---|---|
| Pregunta sencilla | 1.000 | 150 |
| Pregunta con RAG | 8.000 | 500 |
| Análisis de varios documentos | 32.000 | 2.000 |
Representan el 70 %, el 25 % y el 5 % de las solicitudes. La media de entrada es:
La media de salida es:
A una solicitud por segundo, las demandas de entrada y salida son:
Son tasas de demanda de tokens, no FLOPS necesarios ni resultados de un servidor que puedan prometerse al cliente. Sumar 4.300 tokens de entrada y 330 de salida tampoco establece una única capacidad necesaria de 4.630 tokens/s. Las etapas tienen costes distintos, que cambian con los lotes y la longitud del contexto.
Con esa misma tasa de una solicitud por segundo, cada grupo aporta:
| Grupo | Proporción de solicitudes | Demanda de entrada, tokens/s | Demanda de salida, tokens/s |
|---|---|---|---|
| Sencillas | 70 % | 700 | 105 |
| RAG | 25 % | 2.000 | 125 |
| Análisis | 5 % | 1.600 | 100 |
| Total | 100 % | 4.300 | 330 |
Son cifras de un ejemplo, no capacidades medidas de una GPU. Solo el 5 % de las solicitudes genera aproximadamente el 37 % de los tokens de entrada. Una minoría de solicitudes pesadas puede consumir una parte considerable de la capacidad de prefill.
4. Tercer cálculo: ¿cuántas solicitudes coincidirán?
La ley de Little establece una relación útil:
- : número medio de solicitudes presentes en el sistema.
- : tasa media de llegada y finalización en régimen estable.
- : tiempo medio que una solicitud permanece en el sistema.
Con una solicitud por segundo y ocho segundos de tiempo medio de finalización:
Hay ocho solicitudes presentes de media. Si el tiempo sube a 20 segundos al aumentar la carga:
Ahora hay 20 solicitudes sin que cambien el número de usuarios ni la tasa de llegada.
No todas tienen por qué estar ejecutándose en la GPU. Algunas esperan en cola, otras recuperan documentos y otras generan texto. La ley de Little relaciona tasa de paso, solicitudes presentes y tiempo de permanencia; no calcula la capacidad de la GPU. Además, describe un régimen estable y no predice por sí sola las ráfagas repentinas.
5. Cuarto cálculo: ¿cómo ralentiza una cola un sistema rápido?
Consideremos una cola sencilla con tasa de llegada y capacidad de servicio . La utilización es:
Con una capacidad efectiva de dos solicitudes/s y llegadas de una solicitud/s, . Con 1,9 solicitudes/s, . La capacidad media aún supera las llegadas, pero queda muy poco margen.
En el modelo ideal M/M/1, el tiempo medio en el sistema es:
Para solicitudes/s:
| Utilización | Llegadas, solicitudes/s | Tiempo medio en el sistema, segundos |
|---|---|---|
| 25 % | 0,5 | 0,67 |
| 50 % | 1 | 1 |
| 70 % | 1,4 | 1,67 |
| 80 % | 1,6 | 2,5 |
| 90 % | 1,8 | 5 |
| 95 % | 1,9 | 10 |
| 98 % | 1,96 | 25 |
| 99 % | 1,98 | 50 |
La relación exige y los supuestos de M/M/1. La latencia real de vLLM debe medirse bajo carga. En este ejemplo teórico, pasar del 50 % al 95 % eleva el tiempo medio de un segundo a diez.
Un motor de inferencia LLM no es una cola M/M/1. Los lotes continuos, la planificación, las longitudes desiguales y la gestión de la caché KV hacen que la capacidad dependa de la carga.
El ejemplo ilustra un principio, no una predicción de latencia real: maximizar la utilización de GPU no garantiza el mejor servicio. Un asistente corporativo necesita un punto de operación que siga cumpliendo los tiempos exigidos al aumentar la carga, además de vigilar el aprovechamiento del hardware.
6. Quinto cálculo: ¿hay memoria suficiente para esta concurrencia?
La memoria puede agotarse antes que la capacidad de cómputo. Un presupuesto aproximado es:
Para un modelo denso de parámetros almacenados a bits:
Un modelo de 8 mil millones de parámetros con pesos BF16 necesita unos 16 GB de pesos sin comprimir. En una RTX 4090 de 24 GB, eso no deja automáticamente los 8 GB nominales restantes para solicitudes: el entorno de ejecución y los búferes también ocupan memoria.
Además, 16 mil millones de bytes equivalen a unos 14,9 GiB. Conviene convertir pesos, caché y memoria libre real a la misma unidad. El artículo sobre qué abarata y qué cambia la cuantización a cuatro bits explica por qué reducir los pesos no reduce en la misma proporción la caché KV ni la sobrecarga del servicio.
Memoria de la caché KV
En un transformer convencional, la memoria aproximada de caché por token es:
son los bytes por elemento de caché. Para un modelo ilustrativo de 32 capas, ocho cabezas KV, dimensión de cabeza 128 y caché BF16:
Son unos 128 KiB por token activo. Con 30 solicitudes y 19.456 tokens activos en cada una, solo la caché teórica alcanza 71,25 GiB, sin pesos ni sobrecarga. Cambiar esas dos cifras muestra por qué longitud de contexto y concurrencia deben evaluarse juntas.
Herramienta interactiva: modelo, GPU y solicitudes en un mismo cálculo
El modelo ilustrativo usa esa arquitectura. Los paquetes reales toman el tamaño de los archivos de pesos y la geometría del modelo de la tabla LLM. Elige el número de GPU y la distribución; después mueve los controles. Si aún no has elegido hardware, la herramienta propone opciones de la lista de GPU del sitio.
Del número de usuarios al presupuesto de memoria
¿En qué GPU cabe esta carga?
Elige un modelo y una carga. Si aún no has elegido una GPU, la herramienta propone opciones para probar. Que quepa en memoria es una estimación; la velocidad y la calidad del servicio requieren pruebas.
Supuestos de memoria y espacio libre real
Modelo ilustrativo: 8 mil millones de parámetros, pesos BF16 sin comprimir, 32 capas, 8 cabezas KV y dimensión de cabeza de 128. Geometría actual: 32 capas, 8 cabezas KV, dimensión de cabeza 128.
La reserva de 2 GiB es un supuesto de planificación de la tabla, no una medición ni un límite de sobrecarga. Cuantizar los pesos no implica una caché KV de baja precisión: comprueba por separado su compatibilidad y su efecto en la calidad. Esta estimación de atención completa no supone ahorros por caché de prefijos, atención con ventana deslizante, MLA ni arquitecturas híbridas.
Primera opción para comparar: 1 × GeForce RTX 5090
Cabe según la estimación de memoria
- Pesos 14,9 GiB
- KV 8 GiB
- Reserva y otros componentes 2 GiB
Con un reparto equilibrado, se supone que la GPU con más carga atiende 8 solicitudes. Cada GPU carga todos los pesos; las colas y un reparto desigual pueden cambiar esta estimación.
Para una primera evaluación, la clase nominal de memoria de la tabla se trata como un presupuesto en GiB. Antes del despliegue, indica la memoria libre real del dispositivo. Ese límite teórico no establece la capacidad de respuesta con una latencia aceptable.
PCIe; depende del fabricante de la tarjeta · Activa · PCIe 5.0
Especificaciones del fabricante ↗Opciones de GPU para probar
Las opciones proceden de la lista actual de GPU del sitio, ordenadas por menor número de dispositivos y después por capacidad de memoria. Aún hay que comprobar precio, velocidad y compatibilidad del paquete con cada motor. Si hacen falta más dispositivos, el número propuesto aparece junto al nombre de la GPU.
- 1 × GeForce RTX 509032 GB por GPU · margen estimado 7,1 GiB
- 1 × RTX 6000 Ada48 GB por GPU · margen estimado 23,1 GiB
- 2 × GeForce RTX 4090 D24 GB por GPU · margen estimado 3,1 GiB
Las propuestas excluyen productos anunciados, placas no oficiales, memoria unificada y capacidad agregada de varios chips. Para AMD e Intel, comprueba la compatibilidad del paquete, los kernels y el motor en el modelo y sistema operativo concretos.
Explorar la carga de usuarios y la demanda de tokens
- Solicitudes de usuario por segundo
- 0,833
- Llamadas al modelo por segundo
- 0,833
- Demanda de entrada, tokens/segundo
- 3583,33
- Demanda de salida, tokens/segundo
- 275
- Solicitudes en curso; ley de Little
- 6,67
En régimen estable, la ley de Little incluye la cola y todas las etapas del flujo de trabajo. No modifica automáticamente el control de inferencias en ejecución. Entrada y salida se calculan por separado; el tiempo de respuesta supuesto no es una predicción de la herramienta.
Demanda dividida por la capacidad medida: Prefill Requiere pruebas; Decode Requiere pruebas.
Estos cocientes son una primera evaluación. Hay que probar la interacción entre etapas, P95, ráfagas de carga y goodput con una carga mixta. Indica la capacidad medida de toda la configuración; la herramienta no multiplica la velocidad por el número de GPU. Al cambiar el modelo, la distribución o la longitud de solicitud, se borran las mediciones para introducir los resultados de los nuevos ajustes.
Con réplicas independientes, cada GPU conserva el modelo completo y las solicitudes se reparten entre ellas. Al dividir el modelo, la herramienta muestra un presupuesto ideal de reparto uniforme; hay que comprobar aparte la memoria por dispositivo, el soporte del motor y las comunicaciones. El artículo sobre PCIe y SXM en infraestructura de IA explica las distintas opciones de hardware.
El ejemplo depende de la arquitectura descrita. Otras configuraciones GQA, MLA o atención híbrida tienen un comportamiento diferente. La caché KV paginada y la caché de prefijos también pueden modificar la asignación y el uso compartido de memoria.
Concurrencia y longitud de contexto compiten por memoria. Una configuración que atiende muchas solicitudes cortas puede alcanzar el límite con unas pocas solicitudes de contexto 32K.
7. Sexto cálculo: un usuario puede generar varias llamadas
Un asistente basado en agentes complica la relación entre usuario y solicitud. Revisar cinco contratos, extraer cláusulas contradictorias y redactar un informe puede requerir varias llamadas al modelo, algunas secuenciales y otras paralelas.
Si una solicitud de usuario genera una media de llamadas:
Con una solicitud de usuario por segundo y cuatro llamadas por solicitud:
Aun así, contar llamadas no basta. Sus longitudes pueden variar mucho y la salida de una etapa puede alimentar la siguiente. Hay que considerar el grafo de ejecución, las dependencias, el paralelismo posible y los tokens de cada etapa.
| Etapa | Dependencias y posible patrón de ejecución |
|---|---|
| Extraer información de cada contrato | Varias llamadas; los documentos independientes pueden procesarse en paralelo |
| Revisar contradicciones | Depende de la información extraída |
| Recuperar normativa | Puede coincidir con la extracción o esperar a identificar el problema |
| Combinar resultados y redactar el informe | Depende de las salidas anteriores |
Cada etapa puede contener varias llamadas. Es un ejemplo de flujo, no un número fijo de llamadas. La capacidad de un chatbot de preguntas y respuestas para 100 usuarios no se traslada directamente a un asistente basado en agentes.
8. ¿Cómo estimamos la capacidad real?
Una primera aproximación usa la demanda de servicio. Para cada clase de solicitud , sea su proporción y el tiempo equivalente de ocupación de recursos en una configuración de referencia:
En un modelo sencillo de un solo recurso y capacidad fija:
Para inferencia LLM es una aproximación: los lotes pueden cambiar el coste por solicitud, y prefill y decode consumen recursos de forma diferente. Una evaluación técnica útil distingue varias dimensiones:
y son capacidades medidas con una carga de referencia, no FLOPS ni ancho de banda nominales. Estos cocientes permiten una primera evaluación, pero no modelan completamente la interacción entre etapas.
También deben evaluarse por separado recuperación de documentos, reranking, CPU, RAM, red y almacenamiento. La guía de elección de modelo de lenguaje, embeddings y reranker distingue sus funciones. Ejecutarlos en la misma GPU exige compartir el presupuesto de memoria y tiempo. La recuperación puede perjudicar la experiencia aunque el motor LLM aún tenga capacidad libre.
9. La medida final son las respuestas aceptables
Supongamos dos configuraciones que completan cada una 1.000 solicitudes en diez minutos. En la primera, 970 cumplen los requisitos de tiempo y calidad; en la segunda, solo 700.
El throughput es idéntico:
El goodput difiere:
La primera presta más servicio útil, aunque ambas completen el mismo número bruto de solicitudes.
La comparación de Ollama, vLLM, SGLang y llama.cpp también vincula la elección del motor con las condiciones de servicio y despliegue. Las definiciones de métricas de GenAI-Perf ofrecen un punto de partida.
Registra el tiempo hasta el primer token (TTFT), los intervalos de generación (TPOT/ITL), el tiempo de finalización (E2E), P95 y P99, errores y goodput. «Respuesta en menos de tres segundos» es ambiguo: mostrar el primer token en tres segundos es muy distinto de completar una respuesta de 500 tokens en ese tiempo.
10. Convertir «100 usuarios» en una prueba defendible
Define una matriz de carga en lugar de un único escenario:
| Escenario | Usuarios activos | Carga | Objetivo |
|---|---|---|---|
| Uso habitual | 100 | Preguntas breves y RAG | TTFT y goodput |
| Hora punta | 100 | Ráfagas de solicitudes | P95 y crecimiento de la cola |
| Análisis pesado | 25 | Contexto largo y salida extensa | Memoria y E2E |
| Tareas con agentes | 25 | Llamadas en varias etapas | Capacidad del flujo completo |
| Carga mixta | 100 | Todos los grupos | Estabilidad y SLO |
Es una propuesta de prueba, no la especificación de un producto real. Para cada fila, concreta tasa de llegada, distribuciones de longitud de entrada y salida, modelo y versión, motor, estado de caché, límite de latencia y duración.
Aumenta gradualmente la tasa hasta incumplir alguno de los requisitos. Una solicitud exitosa debe cumplir calidad y tiempo: una respuesta incorrecta o tardía no cuenta como goodput.
En servicios multiusuario, combina la prueba de capacidad con una de aislamiento. Como explica el apartado de aislamiento de sesiones y caché, unas colas y un throughput correctos no demuestran separación entre contextos. Usa un identificador o canary distinto por usuario, con la caché activa en la configuración objetivo. Observar contenido de otro usuario debe detener la prueba.
La capacidad utilizable puede definirse así:
Es la mayor tasa de llegada sostenida que cumple todos los requisitos de servicio para la mezcla de carga, la configuración y las condiciones especificadas. Es mucho más precisa que «admite 100 usuarios simultáneos».
11. ¿Necesitan 100 usuarios una H100?
La información disponible no permite una respuesta defendible. Un modelo pequeño cuantizado en una GPU de gama media puede bastar para uso ligero. Un modelo grande con contexto largo puede necesitar varios aceleradores. Quizá convenga derivar preguntas habituales a un modelo pequeño y análisis a uno más potente.
La elección de hardware debe seguir a la definición de la carga. Como señala la guía de modelos de lenguaje, un modelo mayor no siempre es la mejor elección: debe lograr la calidad necesaria y ser viable en velocidad, memoria y coste con el uso real.
El artículo sobre qué tamaño de modelo necesita cada tarea desarrolla ese reparto. Esta herramienta evalúa la memoria; la calidad lingüística y de la tarea debe compararse con ejemplos de la organización, también en persa cuando sea necesario.
El coste puede expresarse por solicitud exitosa:
El coste horario debe incluir amortización, electricidad, refrigeración, mantenimiento e infraestructura. Configuraciones de precios y prestaciones nominales muy distintos pueden ofrecer un valor parecido por respuesta aceptable, o invertir su clasificación aparente.
¿Qué debe prometer un contrato en lugar de «100 usuarios»?
La frase por sí sola no permite elegir GPU, estimar costes ni definir la aceptación técnica. Un compromiso debe especificar patrón de uso, mezcla de solicitudes, longitudes de contexto y salida, modelo y requisitos de tiempo y calidad.
Registra todo ello junto con las versiones del modelo y motor y los ajustes de prueba. El artículo sobre qué entregables debe incluir un contrato de IA relaciona estas condiciones con la entrega del proyecto.
En lugar de preguntar «¿Cuántos usuarios admite este servidor?», conviene preguntar:
¿En qué condiciones completa este sistema cuántas solicitudes útiles, con qué calidad y a qué coste?
Necesitan esa respuesta tanto quien compra un asistente como quien compromete la capacidad de su producto ante un cliente.
Referencias técnicas para pruebas e implementación
- Métricas de NVIDIA GenAI-Perf: inicio y finalización de respuesta, intervalos de tokens y tasa de solicitudes.
- Configuración y optimización de vLLM: falta de KV, interrupción y recálculo, prefill por bloques y división del modelo.
- Estrategias de paralelismo de vLLM: reparto del modelo frente a réplicas que procesan lotes independientes.
Las cifras son ejemplos de cálculo. Un compromiso con el cliente exige probar el modelo, paquete de pesos, motor, hardware y mezcla de carga concretos.