چرا ZTA برای هوش مصنوعی کافی نیست و داده، مدل، خروجی و چرخهٔ حیات چه تهدیدهای تازهای میسازند.
مطالعهٔ فصل: از معماری بدون اعتماد تا هوش مصنوعی بدون اعتماد
شتاب بیسابقه در قابلیتهای هوش مصنوعی، صنایع و الگوهای کسبوکار را متحول کرده است. هوش مصنوعی دیگر فناوریای نوپا نیست، اما ادغام سریع آن ذاتاً چالشهای امنیتی پیچیدهای را نیز به وجود آورده که چارچوبهای سنتی امنیت سایبری برای مقابله با آنها بهطور فزایندهای دچار مشکل هستند. ماهیت پیچیدهٔ سامانههای هوش مصنوعی، دادههای حساسی که مصرف میکنند و تصمیماتی که بر آنها اثر میگذارند، نیازمند تغییر پارادایم در نحوهٔ برخورد ما با امنیت در اکوسیستم هوش مصنوعی است.
مدلهای امنیتی سنتی غالباً به دفاع محیطی و اعتماد ضمنی در شبکهٔ داخلی متکیاند. این مدل برای سامانههای پویا، دادهمحور و توزیعشدهٔ هوش مصنوعی مناسب نیست. هوش مصنوعی، علاوه بر تهدیدهای عمومی امنیت سایبری، بردارهای حملهٔ تازهای مانند مسمومیت داده، وارونگی مدل و نمونههای خصمانه را نیز وارد میکند؛ تهدیدهایی که میتوانند یکپارچگی داده، مالکیت فکری و دقت تصمیمگیری را به خطر بیندازند.
«هوش مصنوعی بدون اعتماد» یا ZTAI اصل جاافتادهٔ «هرگز اعتماد نکنید، همیشه تأیید بگیرید» را از معماری بدون اعتماد به پیچیدگیهای خاص هوش مصنوعی گسترش میدهد. این گسترش فقط دربارهٔ شبکه و دسترسی نیست؛ آسیبپذیریهای ذاتی مدل، خط لولهٔ داده و جریانهای کاری عملیاتی را نیز در بر میگیرد. از این منظر، ZTAI صرفاً تعمیم ZTA نیست، بلکه چارچوبی تخصصی برای نیازمندیهای امنیتی اکوسیستم هوش مصنوعی است.
چرا معماری امنیتی سنتی کافی نبود؟
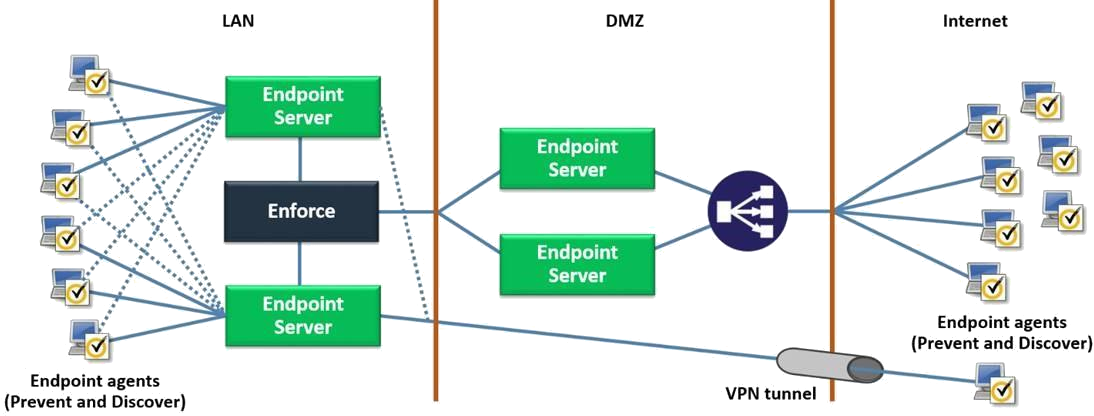
در گذشته، مدلهای امنیتی شبکه عمدتاً بر مفهوم «محیط امن» استوار بودند. فرض بر این بود که هرچه داخل شبکهٔ سازمان قرار دارد قابل اعتماد است و تهدید اصلی از بیرون مرزهای مشخص شبکه میآید. شبکههای ایزوله و کنترل دسترسی در نقاط ورودی و خروجی، پایهٔ این معماری بودند و بعدتر ابزارهایی مانند WAF، سامانههای تشخیص و پیشگیری از نفوذ و ابزارهای جلوگیری از نشت اطلاعات به آن افزوده شدند.
معماری مرسوم و سنتی امنیت شبکه
این معماری نقاط ضعف بنیادینی داشت. با وجود همهٔ لایههای دفاعی، نشت اطلاعات، حملهٔ موفق و نفوذ به سرورها ادامه یافت. عامل انسانی میتوانست موجب نشت داده شود و همین موضوع اساس اعتماد به کارکنان یا ارتباطات بهظاهر امن را زیر سؤال میبرد. گسترش زیرساخت ابری، کار از راه دور و استفاده از دستگاههای شخصی نیز مرز «داخل امن» و «خارج ناامن» را محو کرد.
در پاسخ به این ناکارآمدی، جان کیندرواگ از شرکت Forrester در سال ۲۰۱۰ مفهوم معماری اعتماد صفر، یا به تعبیر دقیقتر «معماری بدون اعتماد»، را مطرح کرد. ایدهٔ محوری آن ساده اما عمیق بود:
هرگز اعتماد نکنید، همیشه تأیید بگیرید.
هیچ کاربر، دستگاه، برنامه یا سامانهای، صرفنظر از آنکه داخل یا خارج شبکه قرار دارد، خودکار قابل اعتماد نیست. هر درخواست دسترسی باید احراز هویت، مجاز و تأیید شود؛ گویی از محیطی کاملاً غیرقابل اعتماد آمده است. این اصل، ایدهٔ «کمترین دسترسی» را به اوج میرساند: پس از احراز هویت نیز فقط حداقل دسترسی لازم برای انجام وظیفه اعطا میشود.
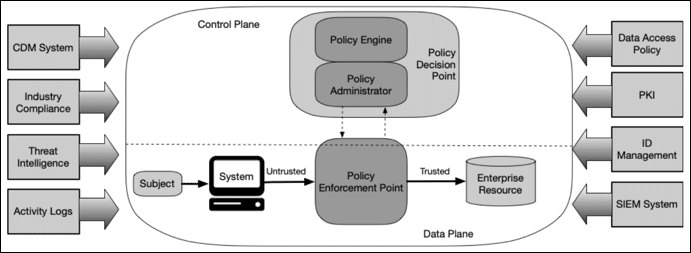
پیادهسازی معماری بدون اعتماد بر احراز هویت قوی و مداوم، کمترین دسترسی، بخشبندی جزئی شبکه، نظارت مستمر، ارزیابی وضعیت دستگاه و کاربر و خودکارسازی فرآیندهای امنیتی بنا میشود. در مدل کلان NIST نیز موتور سیاست دربارهٔ دسترسی تصمیم میگیرد، مدیر خطمشی ارتباط را ایجاد یا قطع میکند و نقطهٔ اعمال سیاست تصمیم را در مسیر ارتباط اجرا میکند. این سه جزء با ورودیهایی مانند وضعیت داراییها، اطلاعات تهدید، سیاستهای دسترسی، PKI، مدیریت هویت، گزارش فعالیت و SIEM تغذیه میشوند.
مدل کلان معماری بدون اعتماد
هوش مصنوعی چه چیزی را عوض میکند؟
معماری بدون اعتماد برای محیط عمومی فناوری اطلاعات چارچوب قدرتمندی است، اما ماهیت هوش مصنوعی به رویکردی هدفمندتر نیاز دارد. تفاوت نخست، پیچیدگی گردش کار است. توسعه، ارائه و نگهداری خدمات یادگیری ماشین به تیمها، فناوریها و چارچوبهای متعددی وابسته است و نقاط ضعف امنیتی میتوانند در هر مرحله از این زنجیره پدیدار شوند.
تفاوت دوم، حجم و حساسیت دادههاست. سامانهٔ یادگیری ماشین حجم زیادی از داده را مصرف و تحلیل میکند و بخشی از این دادهها ممکن است حساس باشند. در نتیجه حفاظت نباید به انتقال داده محدود بماند؛ داده در جمعآوری، پیشپردازش، آموزش و استنتاج نیز باید تحت کنترل باشد.
فرآیندهای هوش مصنوعی هنوز بهطور کامل در رویههای معمول مهندسی نرمافزار و DevSecOps ادغام نشدهاند. این عدم بلوغ، بهویژه هنگام برونسپاری پروژه، میتواند مسئلهساز شود. بستهها و کتابخانههای متنباز نیز برای توسعهٔ یادگیری ماشین حیاتیاند، اما تغییر سریع آنها شناخت ریسک وابستگیهای شخص ثالث را دشوار میکند. از سوی دیگر، ابزارهای امنیتی موجود همیشه دید کافی نسبت به ضعفهای مختص هوش مصنوعی ندارند.
خود مدل نیز مصنوع نرمافزاری متعارفی نیست. فناوری ایجاد، ذخیره و استقرار مدل ممکن است برای تیمهای عملیات فناوری اطلاعات ناآشنا باشد و همین ناآشنایی به پیکربندی نادرست و آسیبپذیری منجر شود. مهمتر آنکه کیفیت داده و خروجی احتمالی مدل را نمیتوان مانند خروجی قطعی یک برنامهٔ سنتی از پیش قابل اعتماد فرض کرد.
تهدیدهای خاص هوش مصنوعی
مسمومیت داده زمانی رخ میدهد که دادهٔ مورد استفادهٔ مدل دستکاری شود و مدل را به نتایج نادرست برساند. وارونگی مدل به مهاجم اجازه میدهد با مطالعهٔ خروجی مدل، اطلاعات حساس را استخراج کند. سرقت مدل دسترسی و استفادهٔ غیرمجاز از مدل آموزشدیده است و نمونهٔ خصمانه ورودیای است که برای فریب مدل و تولید پاسخ نادرست دستکاری شده است.
در بهروزرسانی مسموم، مهاجم بهروزرسانی مدل را تغییر میدهد، کد مخرب وارد میکند یا مدل را به نتایج نادرست سوق میدهد. نشت اطلاعات نیز زمانی رخ میدهد که مدل بتواند اطلاعات حساس موجود در ورودی یا دادهٔ آموزش را آشکار کند. این تهدیدها نشان میدهند امنکردن زیرساخت شبکه برای هوش مصنوعی کافی نیست و یکپارچگی داده، مدل و فرآیند باید در تمام چرخهٔ حیات پیوسته تأیید شود.
تفاوت ZTA و ZTAI در یک نگاه
ویژگی
معماری بدون اعتماد (ZTA)
هوش مصنوعی بدون اعتماد (ZTAI)
فلسفهٔ اصلی
«هرگز اعتماد نکنید، همیشه تأیید بگیرید» برای شبکه و هویت
گسترش همین اصل به داده، مدل، خروجی و گردش کار هوش مصنوعی
تمرکز اصلی
ایمنسازی دسترسی به منابع شبکه و دادههای در حال انتقال
تضمین یکپارچگی، محرمانگی و دسترسپذیری داده، مدل و فرآیند در سراسر چرخهٔ حیات
فرض اعتماد
اعتماد ضمنی محیط داخلی حذف میشود
خروجی مدل، کیفیت داده و یکپارچگی الگوریتم نیز پیشفرض قابل اعتماد نیست
دامنهٔ حفاظت
کاربر، دستگاه، برنامه و شبکه
خط لولهٔ داده، مدل، زیرساخت، گردش کار و کاربران یا دستگاههای تعاملکننده با AI
کنترلهای افزوده
احراز هویت مستمر، کمترین دسترسی، بخشبندی و نظارت
ردیابی اصالت داده، راستیآزمایی یکپارچگی مدل، مقاومت در برابر حملهٔ خصمانه و راستیآزمایی طبقهبندیشدهٔ خروجی
بردارهای حمله
دسترسی غیرمجاز، حرکت جانبی و تهدید داخلی
مسمومیت داده، وارونگی و سرقت مدل، نمونهٔ خصمانه، بهروزرسانی مسموم، نشت اطلاعات و هوش مصنوعی سایه
چرخهٔ حیات
ذاتاً برای چرخهٔ حیات AI طراحی نشده است
در جمعآوری داده، آموزش، ارزیابی، استقرار، نظارت و بازآموزی ادغام میشود
اگر ZTA دروازهٔ دسترسی به یک منبع را کنترل میکند، ZTAI باید خود منبع، مسیر شکلگیری آن و نتیجهای را که تولید میکند نیز دائماً زیر سؤال ببرد. نقطهٔ اتصال این نگاه با مهندسی عملی، MLOps بهمثابه بستر هوش مصنوعی بدون اعتماد است؛ بستری که امکان ردیابی، کنترل و خودکارسازی چرخهٔ حیات مدل را فراهم میکند.
چرخهٔ قابل ردیابی داده، کد، آزمایش، مدل و استقرار بهعنوان پیشنیاز اجرای کنترلهای ZTAI.
مطالعهٔ فصل: MLOps؛ بستر پیادهسازی هوش مصنوعی بدون اعتماد
هوش مصنوعی بدون اعتماد فقط مجموعهای از ابزارهای امنیتی در اطراف مدل نیست. اگر داده، کد، آزمایش، مدل و استقرار در یک فرآیند قابل ردیابی و کنترل قرار نگیرند، راستیآزمایی مستمر نیز در حد یک اصل نظری باقی میماند. MLOps بستری است که این اصول را در چرخهٔ حیات واقعی هوش مصنوعی قابل اجرا میکند.
MLOps یا عملیات یادگیری ماشین، رویکردی مهندسی و مجموعهای از شیوهها برای پیادهسازی و نگهداری قابل اعتماد و کارآمد مدلهای یادگیری ماشین در محیط عملیاتی است. این رویکرد میان علم داده، عملیات توسعه و مهندسی نرمافزار پل میزند تا چرخهٔ حیات مدل از آغاز تا پایان مدیریت شود.
نیازمندیهای چرخهٔ حیات مدرن یادگیری ماشین و هوش مصنوعی
رابطهٔ MLOps و DevOps
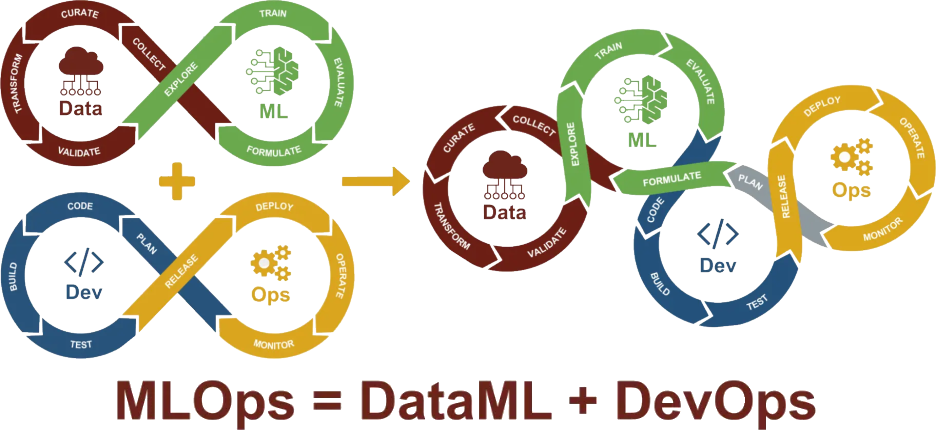
DevOps بر خودکارسازی، نظارت و مدیریت چرخهٔ حیات توسعهٔ نرمافزار، از کدنویسی و ساخت تا آزمایش، انتشار، استقرار و نظارت تمرکز دارد. MLOps این اصول را به مراحل خاص توسعه و استقرار مدل هوش مصنوعی گسترش میدهد: جمعآوری و کاوش داده، آمادهسازی، آموزش، ارزیابی، استقرار، عملیات و نظارت.
هدف مشترک در هر دو، تسریع تحویل، افزایش کیفیت و تضمین پایداری محیط عملیاتی است. تفاوت در آن است که MLOps چالشهایی را نیز در نظر میگیرد که در نرمافزار متعارف یا وجود ندارند یا به این شدت نیستند؛ از جمله وابستگی رفتار مدل به داده، نیاز به بازآموزی و مدیریت مصنوعات مدل.
MLOps حاصل پیوند DataML و DevOps است
چرا MLOps حیاتی است؟
نخستین اثر MLOps، کاهش فاصلهٔ تحقیق تا تولید است. خودکارسازی فرآیندها زمان انتقال مدل از آزمایش به محیط عملیاتی را کم میکند و سازمان میتواند سریعتر به تغییر نیاز یا شرایط پاسخ دهد. این سرعت فقط وقتی ارزش دارد که با قابلیت اطمینان همراه باشد. استانداردسازی مراحل، خطای انسانی را کاهش میدهد و نظارت مداوم به تشخیص زودهنگام مشکل کمک میکند.
اثر دوم، مقیاسپذیری است. سازمان بدون فرآیند مشترک نمیتواند تعداد زیادی مدل را همزمان توسعه، مستقر و نگهداری کند. هر مدل به یک پروژهٔ دستی و وابسته به افراد تبدیل میشود. MLOps زیرساخت و فرآیندی میسازد که این چرخه را تکرارپذیر میکند.
اثر سوم، حکمرانی و انطباقپذیری است. تغییر داده، کد و مدل باید قابل ردیابی باشد. این ردیابی هم برای مقررات امنیت و حریم خصوصی و هم برای بررسی داخلی و خارجی حیاتی است. مدیریت چرخهٔ حیات نیز فقط تا لحظهٔ استقرار ادامه ندارد؛ جمعآوری و آمادهسازی داده، آموزش، اعتبارسنجی، استقرار و پایش عملکرد در محیط واقعی یک چرخهٔ مداوماند.
اجزای چرخهٔ MLOps
مدیریت داده، جمعآوری، پاکسازی، مهندسی ویژگی، نسخهسازی و کاتالوگ داده را در بر میگیرد. مدیریت کد و نسخه، تغییرات کد مدل، اسکریپتهای آموزش و پیکربندیها را دنبال میکند. آموزش و اعتبارسنجی نیز فرآیند آموزش، ارزیابی، تنظیم فراپارامتر و تأیید مدل را تا حد ممکن خودکار میکند.
مدل آموزشدیده بهتنهایی کافی نیست. مصنوعات مدل باید ذخیره، نسخهگذاری و سازماندهی شوند. استقرار مدل نیز باید انتشار آن را در محیطهای مختلف، از سرور و سرویس API تا محیط لبه، قابل کنترل کند. پس از استقرار، عملکرد مدل پیوسته پایش میشود تا انحراف داده، انحراف مدل و نیاز به بازآموزی تشخیص داده شود.
حلقهٔ بازخورد، دادهٔ تازهٔ محیط عملیاتی را به چرخه بازمیگرداند تا مدل دقت و کارایی خود را حفظ کند. امنیت و حکمرانی نیز یک مرحلهٔ جدا در انتهای خط نیست؛ سیاست دسترسی و الزامات انطباق باید در همهٔ مراحل اعمال شوند.
MLOps چگونه به ZTAI تبدیل میشود؟
MLOps بهخودیخود معادل هوش مصنوعی بدون اعتماد نیست. نقش آن فراهمکردن یک چرخهٔ ساختاریافته، خودکار و قابل مشاهده است که بتوان کنترلهای بدون اعتماد را در هر مرحلهٔ آن قرار داد. وقتی داده، کد، آزمایش، مدل و نتیجهٔ ارزیابی نسخهگذاری میشوند، میتوان دربارهٔ اصالت و یکپارچگی آنها تصمیم گرفت. وقتی انتشار مدل از مسیر مشخص انجام میشود، میتوان یک نقطهٔ اعمال سیاست داشت. وقتی عملکرد مدل و تغییر داده پایش میشود، راستیآزمایی از لحظهٔ ورود کاربر فراتر میرود و به تمام عمر سامانه گسترش مییابد.
این مسیر یکباره طی نمیشود. سازمان ممکن است از فرآیندهای دستی و پراکنده شروع کند و مرحلهبهمرحله به خودکارسازی، CI/CD و آموزش مستمر برسد. مدل بلوغ ZTAI از سطح صفر تا چهار این گذار را بهتفصیل توضیح میدهد و نشان میدهد چرا سطح چهار فقط «MLOps بهتر» نیست، بلکه به حذف دسترسی مستقیم انسان به دادههای حساس نزدیک میشود.
گذار از فرآیند دستی و پراکنده به خودکارسازی کامل و امکان حذف دسترسی مستقیم انسان به دادهٔ حساس.
مطالعهٔ فصل: مدل بلوغ هوش مصنوعی بدون اعتماد؛ از سطح صفر تا چهار
پیادهسازی هوش مصنوعی بدون اعتماد یک فرآیند تدریجی است. نقطهٔ آغاز بسیاری از سازمانها چند اسکریپت، چند فایل مدل و تیمهایی است که جدا از یکدیگر کار میکنند؛ نقطهٔ پایان، معماریای است که در آن داده، آموزش، ارزیابی و استقرار در مرزهای مشخص و قابل کنترل انجام میشوند و انسان میتواند از دسترسی مستقیم به دادههای حساس حذف شود.
این سطحبندی، برداشتی نوین بر پایهٔ مدلهای بلوغ معماری بدون اعتماد CISA و تصاویر معماری MLOps مایکروسافت است؛ تصاویر این بخش بر مبنای پیاده سازی مایکروسافت، در اینجا برای صورتبندی مسیری به کار رفتهاند که از بلوغ مهندسی هوش مصنوعی آغاز میشود و به هوش مصنوعی بدون اعتماد میرسد، بهویژه در سطح چهار که تفسیر ارائهشده فراتر از بیان متعارف MLOps است.
پیشنیاز فهم این مدل، شناخت MLOps بهعنوان بستر عملی ZTAI است. سطوح صفر تا سه بیش از هر چیز بلوغ مهندسی و عملیاتی را میسازند؛ سطح چهار جایی است که این بلوغ میتواند برای اجرای واقعی اصول بدون اعتماد به کار گرفته شود.
سطح صفر: دستی و هرجومرج
در سطح صفر، فرآیندهای امنیتی و مهندسی هوش مصنوعی عمدتاً دستی و پراکندهاند. دانشمندان داده معمولاً جدا از بقیهٔ تیم کار میکنند و حتی اگر مهندسان داده حضور داشته باشند، تعامل آنها با سایر اعضا محدود است. مهندس نرمافزار مدل را بهصورت دستی و با روشهای سنتی از تیم داده میگیرد و برنامه را پیرامون آن مینویسد.
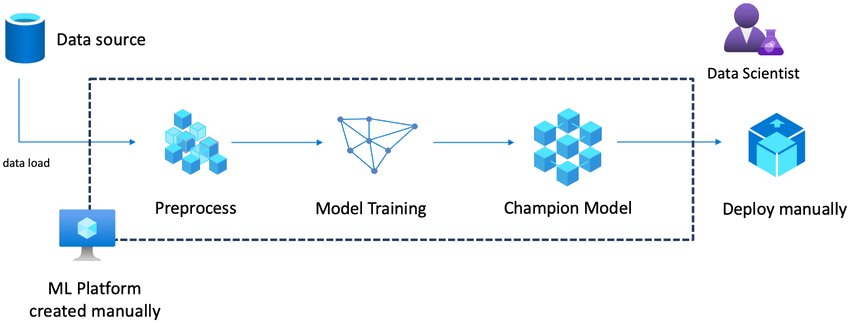
گردآوری داده تدریجی و دستی است، محاسبات تقریباً مدیریت نمیشوند و آزمایشها بهدرستی دنبال و مستند نمیشوند. مدل نهایی ممکن است فقط یک فایل یا برنامه با ورودی و خروجی مشخص باشد. استقرار نیز کاملاً دستی است. اسکریپتهای ارزیابی معمولاً پس از تولید مدل نوشته میشوند و نسخهگذاری ندارند. فرآیند تأیید استاندارد نیست و نسخهٔ نهایی ممکن است توسط برنامهنویس، مهندس داده یا حتی دانشمند داده مستقر شود.
بلوغ سطح صفر: فرآیند دستی و وابسته به افراد
در این سطح، بازتولید مدل بسیار دشوار است؛ افراد از ابزارها، کدها و اسکریپتهای متنوعی استفاده میکنند که ممکن است تغییر کرده یا به اشتراک گذاشته نشده باشند. آزمایشها از پیش تعیین نشدهاند و در سطح سازمان به اشتراک گذاشته نمیشوند. امکان نشت داده و مدل به دلیل اتکا به افراد بالاست و عملاً حکمرانی داده وجود ندارد.
فرآیندها مقیاسپذیر نیستند و منابع پردازش سریع مانند GPU بهدرستی میان افراد سازمان به اشتراک گذاشته نمیشوند. منابع داده نیز برای فعالیت یادگیری ماشین آماده نیستند و هر استفاده به اسکریپت و کار دستی تازه نیاز دارد.
سطح یک: پایهای و مدیریتشده
در سطح یک، نقش افراد هنوز تفاوت بنیادینی با سطح صفر ندارد. دانشمندان داده همچنان ایزولهاند، مهندسان داده تعامل محدودی دارند و مهندسان نرمافزار فقط با ابزارهای مدیریت کد تا اندازهای وضعیت بهتری پیدا کردهاند.
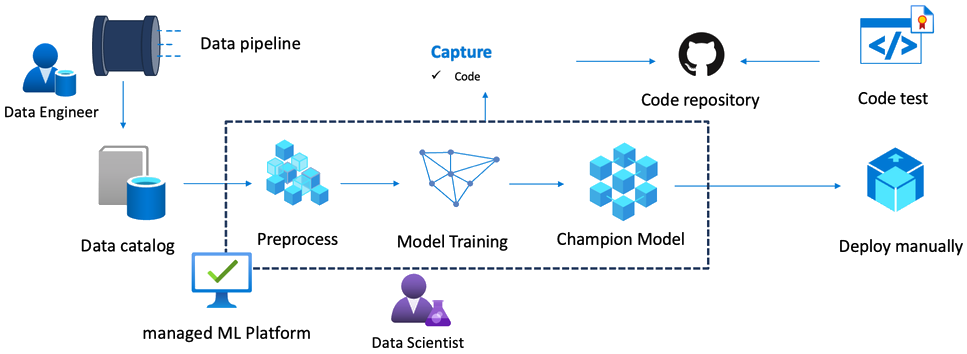
فرآیند گردآوری داده خودکار میشود، اما پردازش داده میتواند مدیریتشده یا مدیریتنشده باشد. آزمایشها همچنان بهدرستی مدیریت نمیشوند و مدلهای خروجی مانند سطح صفر، هرکدام فایلی با ورودی و خروجی مشخصاند. انتشار مدل دستی است. اسکریپتهای ارزیابی نسخهگذاری میشوند، اما همچنان دستی تولید میشوند و مدل در روالی مشخص به برنامهنویس تحویل داده میشود تا استقرار را انجام دهد.
بلوغ سطح یک: گردآوری داده خودکار شده، اما مدل و استقرار هنوز دستیاند
آزمایش کیفی معمولاً پیش از استقرار انجام میشود و تولید نسخهٔ انتشار میتواند خودکار باشد. بااینحال، کیفیت هنوز به مهارت افراد وابسته است. تنوع ابزارها مدیریت یکپارچهٔ تیم را دشوار میکند، تضمین کیفیت عمدتاً به بخش نرمافزار محدود میماند و مدل کنترل کیفی درست ندارد. احتمال نشت داده و مدل همچنان بالاست و حکمرانی داده شکل نگرفته است. مشکل اشتراک منابع GPU نیز حل نشده است.
سطح دو: خودکارسازی اولیه همراه با ردیابی
در سطح دو، دانشمند داده با مهندس داده برای تولید کد و فرآیندهای خودکار همکاری میکند. مهندس داده در تعامل مستقیم با دانشمند داده است. مهندس نرمافزار هنوز تعامل نزدیکی با این دو گروه ندارد، اما مدل را بهصورت خودکار دریافت میکند.
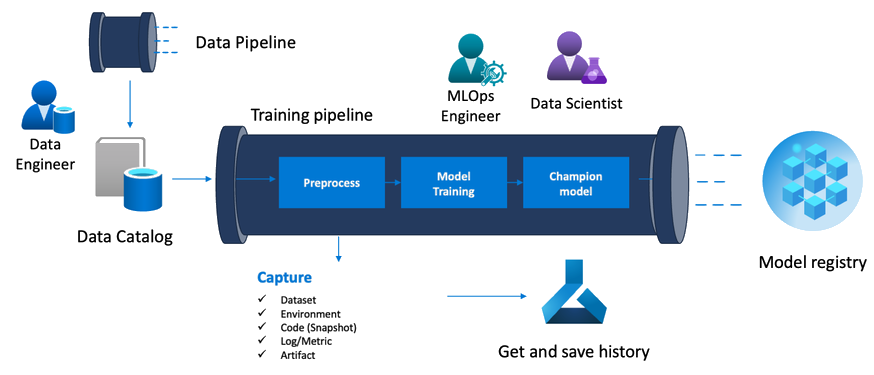
گردآوری داده خودکار و پردازش آن کاملاً مدیریتشده است. آزمایشها دنبال و نسخهگذاری میشوند. کد، اسکریپت، داده، مدل و برنامهٔ نهایی همگی نسخه دارند. با وجود این، انتشار مدل هنوز دستی است. اسکریپتهای ارزیابی همراه با نتیجهٔ ارزیابی ذخیره میشوند و نسخهٔ انتشار را برنامهنویس مدیریت میکند.
بلوغ سطح دو: پردازش مدیریتشده و ردیابی اجزای چرخه
در این سطح میتوان کیفیت بخشهای مختلف را دنبال کرد و سامانه شفافتر میشود، اما اثر این کنترلها در نسخهٔ مستقر هنوز کامل نیست. هنوز روشن نیست کیفیت مدل چگونه به کیفیت محصول نهایی تبدیل میشود. نشت داده و مدل به دلیل اتکا به افراد ممکن است و حکمرانی داده کامل نیست. مقیاسپذیری منابع توسعه و استقرار در چند نقطه نیز هنوز مسئله است.
سطح سه: استقرار خودکار و CI/CD
در سطح سه، دانشمند داده، مهندس داده و مهندس نرمافزار در تعامل مستقیماند. مهندس داده ورود و خروجیها را با همکاری هر دو گروه مدیریت میکند و فرآیندهای گردآوری و پردازش داده خودکار و مدیریتشدهاند. آزمایشها همراه با نتایج نسخهگذاری میشوند و همهٔ اجزا، از کد و اسکریپت تا داده، مدل و برنامهٔ نهایی، قابل ردیابیاند.
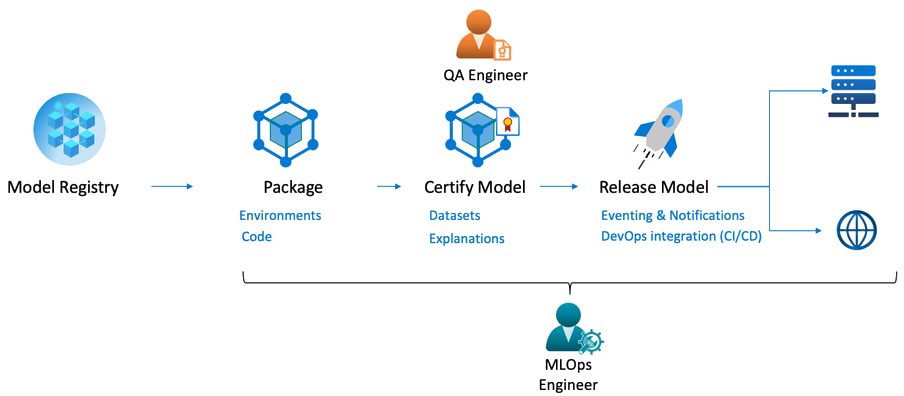
مدل بهصورت دقیق و نیمهخودکار ارزیابی کیفی میشود. انتشار خودکار است، اسکریپت و نتیجهٔ ارزیابی ذخیره میشوند و فرآیند توسعه و استقرار توأم یا CI/CD امکان بهرهبرداری واقعی پیدا میکند. آزمایشهای قطعهای و کنترل کیفی برای هر مدل انجام میشوند و کیفیت، به دلیل خودکارشدن ارزیابی، کمتر به یک فرد خاص وابسته است. مهندس کنترل کیفیت و DevOps بر فرآیند نظارت میکنند.
بلوغ سطح سه: CI/CD و دروازهٔ ورود به هوش مصنوعی بدون اعتماد
سطح سه پایان مسیر نیست. تنوع ابزارها کمتر شده، اما از بین نرفته است. کیفیت مدل و محصول قابل کنترل شده، بااینحال ممکن است مدل در آزمایش بهتر شود اما تجربهٔ کاربر در محیط عملیاتی بهبود پیدا نکند. امکان نشت داده و مدل هنوز وجود دارد و حکمرانی داده کامل نیست، هرچند با اعمال محدودیت میتوان ریسک را کاهش داد.
استقرار روی چند گره و مدیریت منابع بهرهبرداری بهبود یافته، اما منابع آموزش همچنان میتوانند چالشبرانگیز باشند. مهمتر آنکه فرآیند عمدتاً یکطرفه است و بازخورد مدل مستقر بر چرخهٔ تولید اثر نمیگذارد. استقرار نسخهٔ تازه بدون توقف خدمت نیز لزوماً حل نشده است.
سطح چهار: خودکارسازی کامل و امکان حذف عامل انسانی
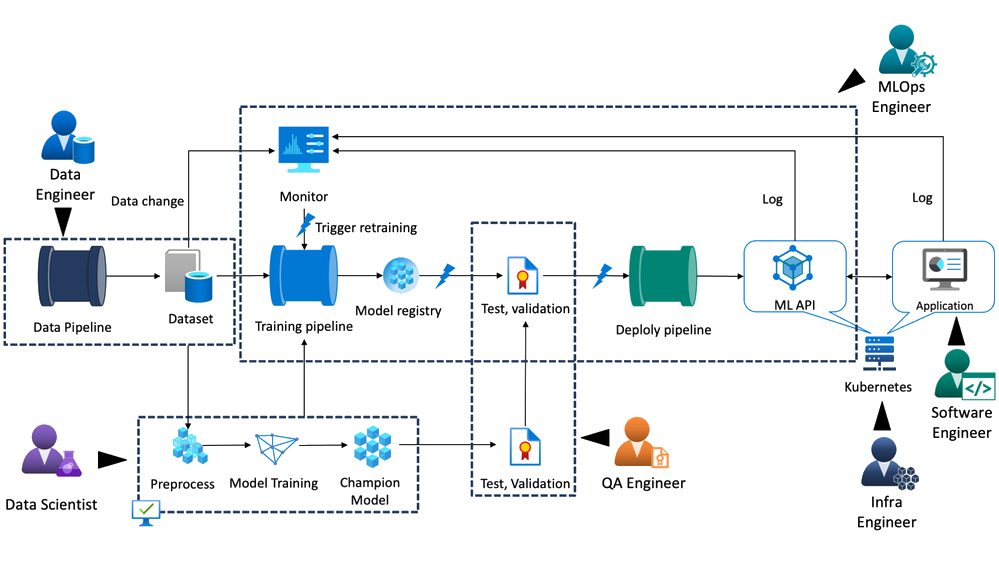
در سطح چهار، هر سه گروهِ دانشمندان داده، مهندسان داده و مهندسان نرمافزار یا MLOps بر خودکارسازی همهٔ فرآیندها، از مهندسی داده تا استقرار و کنترل کیفیت، نظارت میکنند. انسان میتواند از ورود مستقیم به بخشهای دادهمحور حذف شود و نقش او به ناظر یا تعریفکنندهٔ فرآیند تقلیل یابد؛ بنابراین میتوان حق دسترسی مستقیم به داده را از او سلب کرد.
گردآوری داده خودکار است و بازآموزی مدل میتواند خودکار فعال شود. آزمایشها همراه با نتایج نسخهگذاری میشوند و تمام اجزای تولید و خود فرآیندها قابل ردیابیاند. مدل بهصورت دقیق و خودکار ارزیابی میشود و بازخورد کاربر در تولید نسخهٔ بعدی اثر میگذارد.
انتشار خودکار است و CI/CD با آموزش مستمر یا CT تکمیل میشود. آزمایشهای قطعهای، کنترل کیفیت و آزمایشهای جعبهسیاه برای هر نسخهٔ مدل خودکار اجرا میشوند و متخصصان کنترل کیفیت و عملیات بر فرآیند نظارت دارند.
بلوغ سطح چهار: خودکارسازی کامل، بازخورد و آموزش مستمر
این سطح در سازمانی که در یک شبکهٔ پیوسته فعالیت میکند بالاترین کارکرد و امنیت را ارائه میدهد، اما همانگونه که در تصویر دیده میشود، نیروی انسانی هنوز در بخشهای مختلف بهعنوان ناظر و مداخلهکننده حضور دارد. برای دادههای سری و فوقمحرمانه همین حضور نیازمند بازنگری است.
تفکیک محیط توسعه و تولید
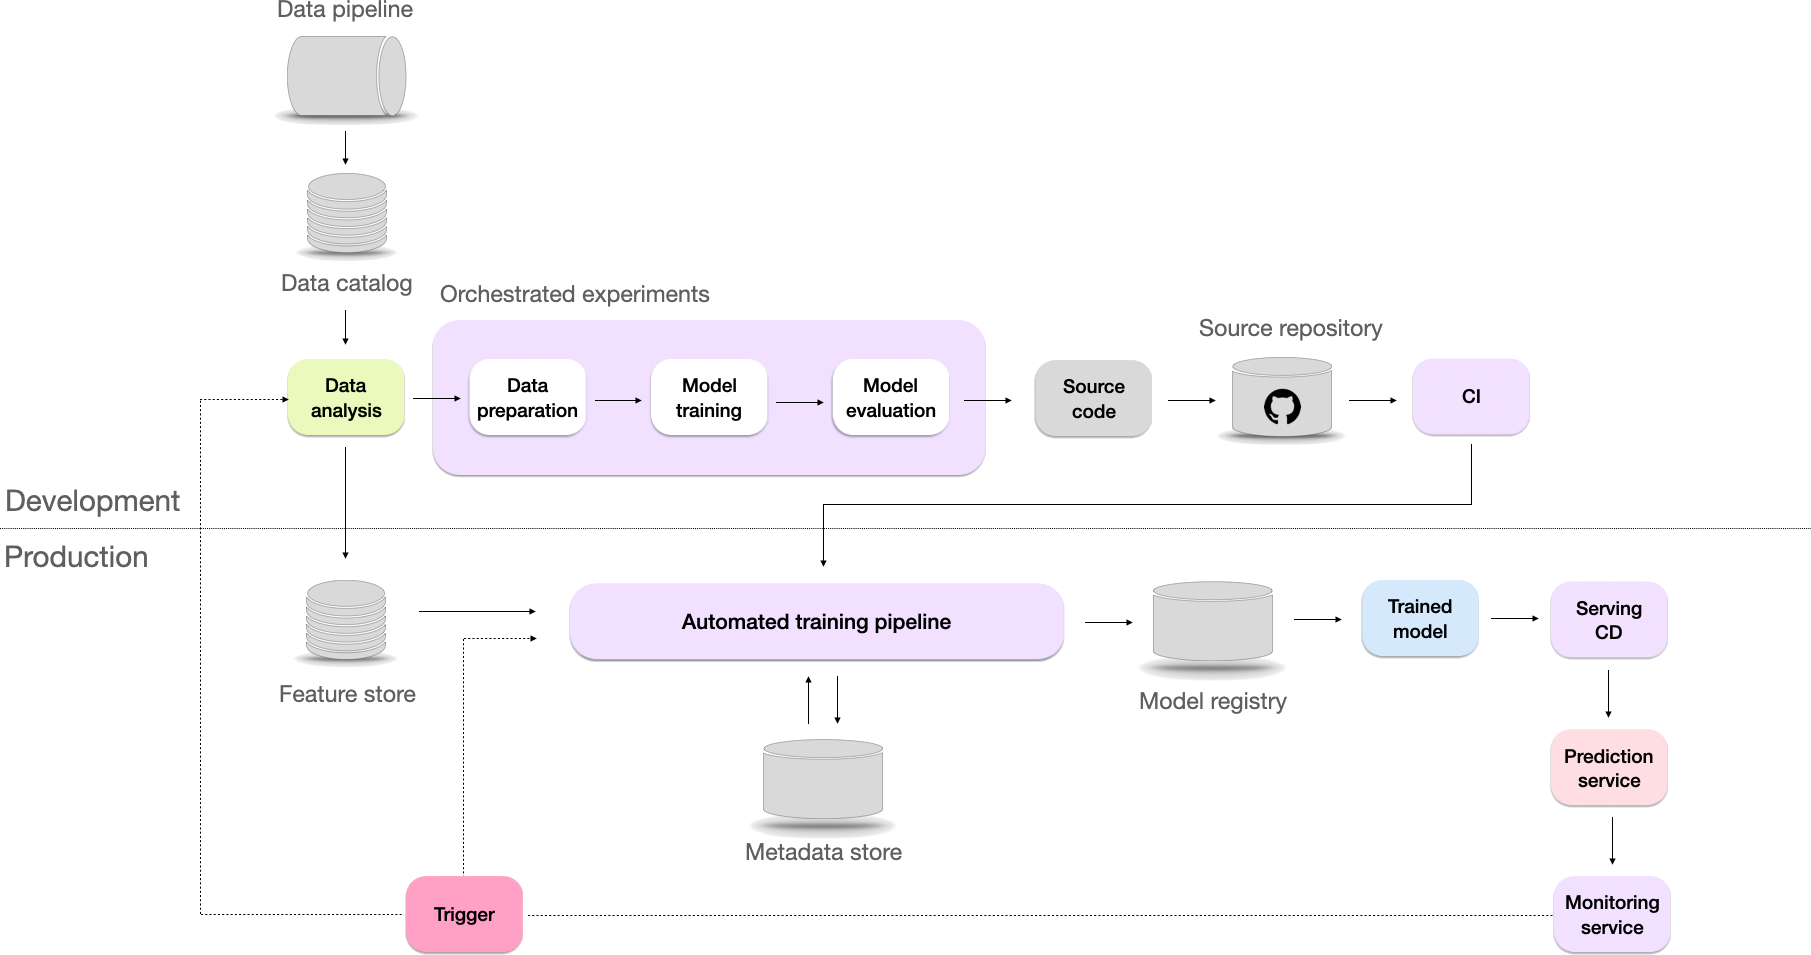
در برداشت دوم از سطح چهار، مرز مشخصی میان توسعه و تولید ایجاد میشود. با خودکارسازی کامل فرآیندهای تولید، نقش انسان به ناظر کاهش مییابد. دادهٔ محرمانه از دادهٔ عمومی جداست و خط لولهٔ آموزش اصلی در محیط تولید و امن قرار میگیرد. تیم توسعه با دادهٔ عمومی، مصنوعی یا بینامشده کار میکند و اجازهٔ دسترسی مستقیم به دادهٔ محرمانه ندارد.
سطح چهار با تفکیک محیط توسعه و تولید و حذف دسترسی مستقیم تیم توسعه به دادهٔ محرمانه
در این معماری چهار مرز حیاتی برای وظایف هوش مصنوعی شکل میگیرد:
خط لولهٔ داده: مهندس داده ورود داده و تعریف فرآیند تحلیل و آمادهسازی را مدیریت میکند، اما اجرای فرآیند در مرز کنترلشده انجام میشود.
خط لولهٔ آموزش: دانشمند داده فرآیند و پارامترهای آموزش را تعریف میکند، اما آموزش خودکار است و خروجی به رجیستری مدل وارد میشود. سامانهٔ مانیتورینگ عملکرد را پیوسته رصد میکند و در صورت تغییر داده میتواند بازآموزی را فعال کند.
ارزیابی و اعتبارسنجی: مدل آموزشدیده بهصورت خودکار یا نیمهخودکار ارزیابی میشود. آزمونهای قطعهای و جعبهسیاه بخشی از همین مسیرند.
خط لولهٔ استقرار: پس از تأیید مدل، استقرار بهصورت خودکار انجام میشود و مدل میتواند بهعنوان API روی زیرساخت عملیاتی منتشر شود. مهندس نرمافزار و زیرساخت برنامهٔ مصرفکنندهٔ این API را توسعه میدهند، نه اینکه مستقیماً در داده و آموزش دخالت کنند.
این چهار مرز نشاندهندهٔ یکپارچگی عمیق MLOps و اعتماد صفرند. تنها خروجی تأییدشده و منطبق با سیاست به محیط عملیاتی میرسد. انسان مدیر سیاست و ناظر فرآیند است و دخالت مستقیم او در دادهٔ حساس یا آموزش مدل میتواند حذف شود.
صورتبندی برای محیطهای با ماموریتهای حساس
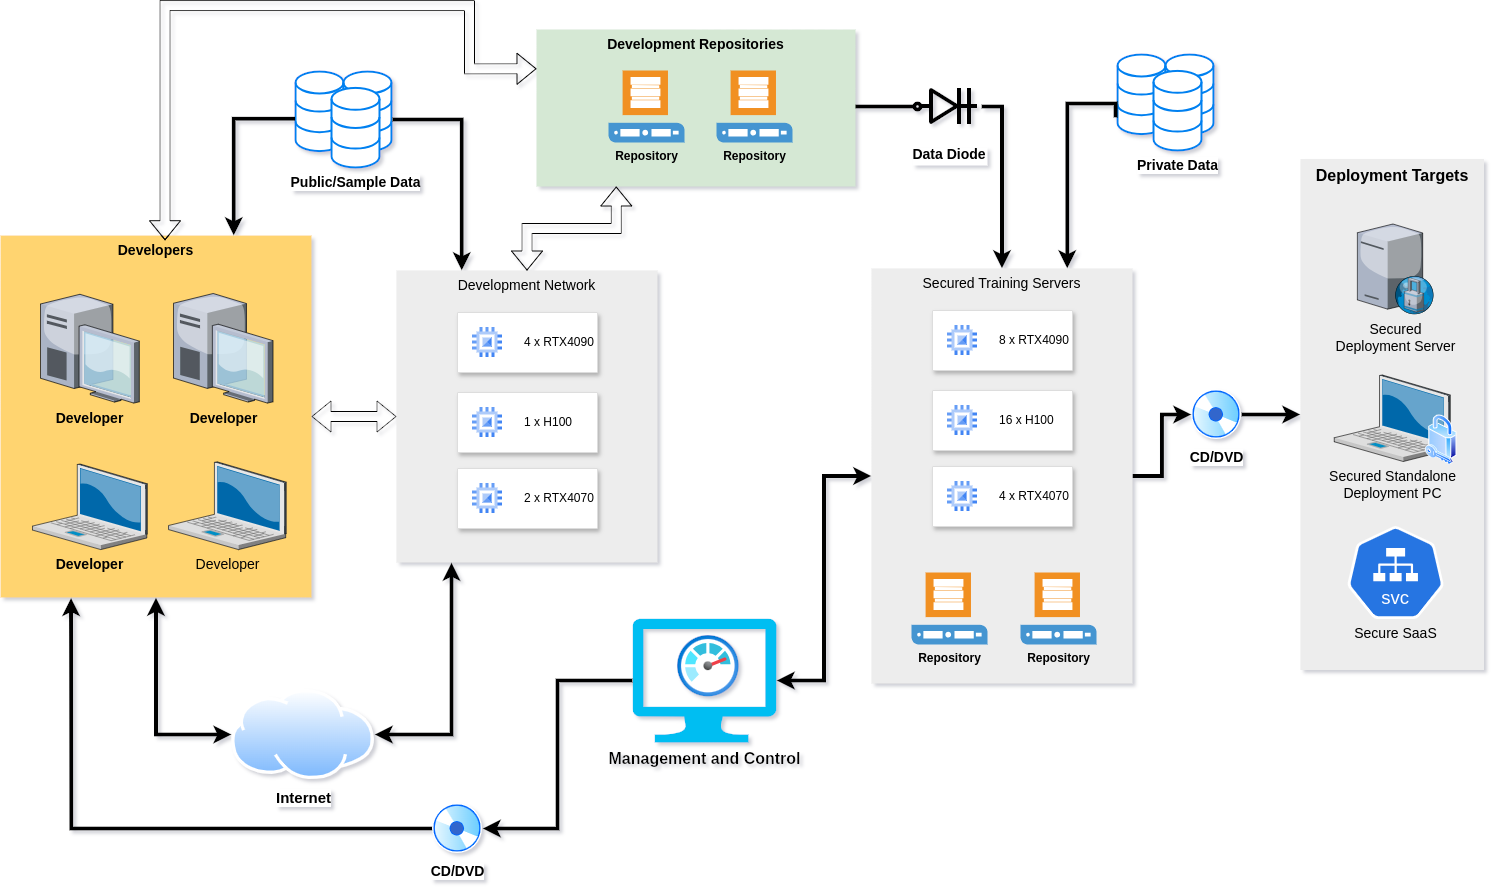
در سازمانهای با ماموریت ویژه که دادهٔ سری و فوقمحرمانه دارند، اجرای کامل CI/CD/CT ممکن است به دلیل محدودیت شبکه یا هزینه دشوار باشد. در این حالت میتوان نسخهای سفارشیشده و تقلیلیافته از سطح چهار ساخت: تیم توسعه به دادهٔ محرمانه دسترسی ندارد و توسعه را با دادهٔ عمومی یا بینامشده انجام میدهد؛ آموزش نهایی روی دادهٔ محرمانه در محیط امن و ایزوله بهصورت خودکار اجرا میشود و حتی مدیر سامانه نیز دسترسی مستقیم به داده ندارد.
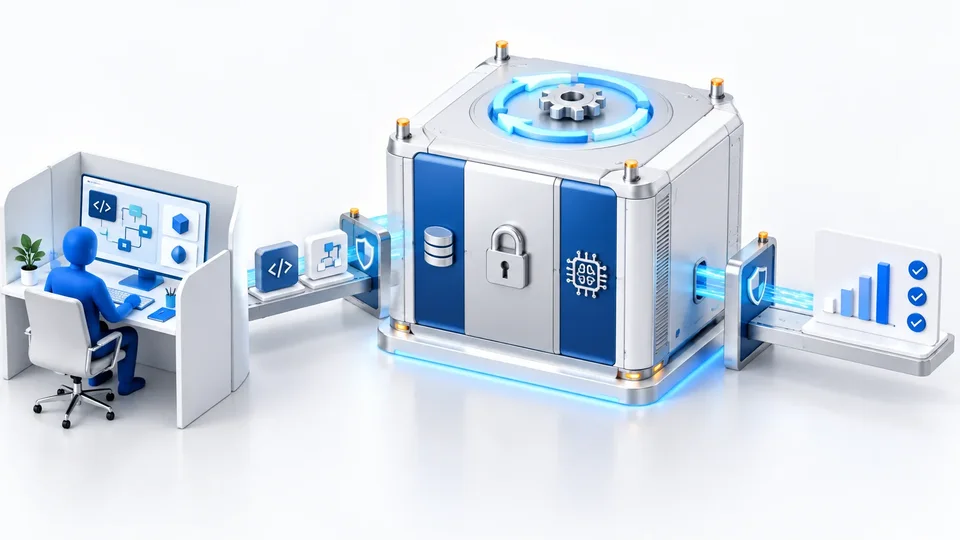
نمونهٔ معماری ZTAI برای محیطهای دارای ماموریتهای حساس و دادههای فوقمحرمانه
در این سطح، حذف انسان به معنی حذف مسئولیت انسانی نیست. انسان هنوز سیاست را تعریف میکند، فرآیند را میسازد، بر شواهد نظارت دارد و در استثناها مداخله میکند؛ آنچه حذف میشود دسترسی مستقیم و غیرضروری به دادهٔ خام و امکان دورزدن مسیر کنترلشده است.
مقایسهٔ سطوح بلوغ
سطح
ویژگیهای کلیدی
فعالیتهای اصلی
چالش امنیتی و عملیاتی
صفر؛ دستی و پراکنده
تیمهای ایزوله و استقرار کاملاً دستی
گردآوری دستی داده، محاسبهٔ مدیریتنشده و مدل بهشکل فایل
بازتولید دشوار، نشت بالا، نبود حکمرانی داده و مقیاسپذیری
یک؛ پایهای
گردآوری خودکار داده و نسخهگذاری اولیه
انتشار دستی و آزمایش کیفی پیش از استقرار
تضمین کیفیت عمدتاً برای نرمافزار، نشت بالا و مشکل اشتراک GPU
دو؛ مدیریت و ردیابی
پردازش مدیریتشده و نسخهگذاری همهٔ اجزا
ذخیرهٔ نتیجهٔ ارزیابی و تحویل خودکار مدل
انتشار همچنان دستی، حکمرانی ناکامل و استقرار محدود
سه؛ CI/CD
همکاری مستقیم سه تیم و ارزیابی نیمهخودکار
انتشار خودکار و آزمون برای هر مدل
فرآیند یکطرفه، بازخورد ناکامل و باقیماندن امکان نشت
چهار؛ خودکارسازی کامل
نقش انسان به ناظر و مدیر فرآیند تقلیل مییابد
CI/CD/CT، بازآموزی و ارزیابی خودکار
نیاز به تفکیک بیشتر برای دادهٔ فوقمحرمانه و هزینهٔ اجرای کامل
مدل بلوغ قرار نیست به سازمان یک برچسب تزئینی بدهد. کارکرد آن این است که نشان دهد کدام کنترل در وضعیت فعلی واقعاً قابل اجراست و گام بعدی چیست. اصولی مانند کمترین دسترسی یا راستیآزمایی مستمر، بدون نسخهگذاری و مسیر خودکار در سطح شعار میمانند. اصول و کنترلهای عملی ZTAI توضیح میدهد این بلوغ باید در امنیت داده، مدل، زیرساخت و خروجی چگونه مصرف شود.
راستیآزمایی، کمترین دسترسی، فرض نفوذ و کنترلهای داده، مدل، زیرساخت و خروجی.
مطالعهٔ فصل: اصول و کنترلهای عملی هوش مصنوعی بدون اعتماد
پیادهسازی ZTAI صرفاً بهکارگیری چند ابزار امنیتی نیست؛ نیازمند تغییر نگرش فکری و عملیاتی است. اصول معماری بدون اعتماد باید با پیچیدگیهای خاص داده، مدل، خروجی و چرخهٔ حیات هوش مصنوعی تطبیق پیدا کنند. تفاوت ZTA و ZTAI نقطهٔ آغاز است، اما این مقاله به خود کنترلها میپردازد.
راستیآزمایی صریح و مستمر
اصل بنیادین ZTA در هوش مصنوعی به معنی تأیید مداوم هویت و مجوز برای هر درخواست دسترسی به داده، مدل و منابع هوش مصنوعی است. این تأیید فقط در نقطهٔ ورود انجام نمیشود؛ در سراسر چرخهٔ حیات، از جمعآوری داده تا آموزش و استنتاج، و در هر تعامل با سامانه ادامه دارد.
راستیآزمایی مستمر برای هوش مصنوعی به یک مدل پویای ارزیابی ریسک نیاز دارد که فراتر از سیاست ثابت عمل کند. مدل بازآموزی میشود، داده تغییر میکند و رفتار کاربر یا سرویس ثابت نمیماند. سامانهٔ امنیتی باید بتواند با این تغییرها سازگار شود و سیاست را بر اساس ریسک تازه تنظیم کند.
کمترین دسترسی؛ نه فقط برای کاربر، برای مدل و داده
هر کاربر، دستگاه، سرویس و حتی مدل هوش مصنوعی باید فقط حداقل دسترسی لازم برای وظیفهٔ خود را داشته باشد. این دسترسی میتواند بر اساس نقش، ویژگی و ریسک بهصورت پویا تنظیم شود.
در محیط هوش مصنوعی، کمترین دسترسی از محدودکردن شبکه فراتر میرود و به دسترسی دانشمند داده و مهندس هوش مصنوعی به داده و مدل میرسد. با توجه به حجم و پیچیدگی دادههای آموزش، این باور که دانشمند داده برای انجام کار خود باید کل مجموعهداده را مستقیم و چشمی ببیند، قابل دفاع نیست. بررسی بصری چنین حجمی عملاً ممکن و مفید نیست.
در معماری پیشرفتهٔ ZTAI، دانشمند داده میتواند بدون دسترسی مستقیم به دادهٔ خام مدل را توسعه دهد. ابزارهای آماری، دادهکاوی و فرآیند خودکار ETL میتوانند الگو، توزیع و رابطهٔ موجود در داده را نشان دهند، بدون آنکه جزئیات حساس در اختیار انسان قرار گیرد. دسترسی انسان میتواند به شمای ساختار داده یا زیرمجموعهٔ کوچک و بینامشده محدود شود. درخواست آموزش با پارامترهای مشخص به محیط ایزوله ارسال میشود و مدل روی دادهٔ محرمانه، بدون دخالت مستقیم انسان، آموزش میبیند.
این صورتبندی به سطح چهار مدل بلوغ ZTAI وابسته است؛ جایی که چهار مرز داده، آموزش، ارزیابی و استقرار شکل گرفتهاند و انسان مدیر سیاست و ناظر فرآیند است.
تفکیک توسعه و تولید برای حذف دسترسی مستقیم انسان به دادهٔ محرمانه
فرض نقض امنیتی و آمادگی برای آن
معماری بدون اعتماد بر این فرض عمل میکند که نقض امنیتی اجتنابناپذیر است و سامانه ممکن است از قبل به خطر افتاده باشد. در ZTAI این فرض از سازش شبکه فراتر میرود و دستکاری مدل یا مسمومیت داده را نیز شامل میشود. بنابراین راستیآزمایی یکپارچگی مدل و اصالت داده باید مستمر باشد؛ تمرکز نباید فقط بر جلوگیری از دسترسی اولیه بماند، بلکه مهار و بازیابی سریع نیز بخشی از طراحی است.
در بالاترین سطح، دسترسی مستقیم انسان به داده میتواند حذف شود. داده در سیلوی امن و ایزوله باقی میماند و تعامل با آن فقط از طریق API و فرآیند خودکار، زیر نظر موتور سیاست، انجام میشود. در این مدل حتی مهندس و مدیر سیستم نیز لزوماً دادهٔ حساس را نمیبینند و داده فقط برای آموزش یا استنتاج در محیط کنترلشده مصرف میشود.
فلسفهٔ این رویکرد، حفاظت همزمان از «خون» سازمان، یعنی دادهٔ خام، و «عصاره» آن، یعنی مدل آموزشدیده، است. معماری باید چنان طراحی شود که نفوذ به یک لایه، دسترسی به دادهٔ اصلی یا حرکت جانبی گسترده را ممکن نکند. شعار این رویکرد را میتوان چنین خلاصه کرد: «دربها را با دیوارهای نفوذناپذیر جایگزین کنیم.»
راستیآزمایی طبقهبندیشدهٔ خروجی
خروجی مدلهای هوش مصنوعی، بهویژه مدلهای مولد، احتمالی و تا حدی پیشبینیناپذیر است. ZTAI اعتماد پیشفرض به خروجی مدل را رد میکند، اما همهٔ خروجیها را نیز یکسان پرخطر نمیبیند. میزان راستیآزمایی باید با ریسک و پیامد خروجی متناسب باشد.
خروجی کمخطر، مانند خلاصهٔ داخلی یا پیشنهاد فراداده، میتواند از کنترل خودکار و نظارت سبک عبور کند. خروجی با ریسک متوسط به یک لایهٔ نظارت انسانی نیاز دارد. خروجی پرخطر که بر مشتری، امور مالی، سلامت، عملیات یا مسائل حقوقی اثر میگذارد باید ردیابی کامل، کنترل نسخه و تأیید صریح داشته باشد.
این طبقهبندی، عدم قطعیت ذاتی هوش مصنوعی را در معماری جذب میکند. اگر هر خروجی به سنگینترین کنترل ممکن نیاز داشته باشد، راستیآزمایی به گلوگاه تبدیل میشود؛ اگر همهٔ خروجیها یکسان قابل اعتماد فرض شوند، کنترل معنای خود را از دست میدهد. نظام طبقهبندیشده امکان مقیاسپذیری را فراهم میکند و منطق حکمرانی سازمان را به خروجی ماشین گسترش میدهد.
تقویت تدریجی از طریق بازخورد و خودکارسازی
کنترل ریسک در ZTAI نباید ایستا باشد. سامانهٔ راستیآزمایی با استفادهٔ مداوم بهبود مییابد: بازبینها سریعتر میشوند، الگوهای تکراری خودکار میشوند و تصمیمهای کمخطر به نظارت سبکتر منتقل میشوند. هر خروجی تأییدشده میتواند توان سامانه را در شناخت موارد خاص، آموزش مدل و کاهش عدم قطعیت افزایش دهد.
راستیآزمایی در این حالت فقط یک محافظ نیست؛ اهرمی عملیاتی برای بهبود کیفیت و کاهش بررسی دستی است. این فلسفه با نظارت مستمر در ZTA و بازخورد و بازآموزی در MLOps همراستاست. هوش مصنوعی بدون اعتماد یک وضعیت امنیتی ثابت نیست، بلکه سامانهای در حال تکامل است.
امنیت داده در سراسر چرخهٔ حیات
ایمنسازی دادهٔ هوش مصنوعی بسیار فراتر از رمزنگاری سنتی است. اصالت، یکپارچگی و طبقهبندی داده باید از جمعآوری تا استنتاج حفظ شود و هر تبدیل دادهای قابل راستیآزمایی باشد.
رمزنگاری جامع باید داده را در حال سکون، انتقال و پردازش پوشش دهد. برای محاسبات حساس میتوان تکنیکهایی مانند رمزنگاری همریخت یا محیطهای محصور امن را نیز بررسی کرد تا پردازش دادهٔ رمزنگاریشده یا محاسبهٔ محلی ممکن شود.
پنهانسازی، بینامسازی و مبهمسازی برای محیط توسعه و آزمایش اهمیت دارند؛ محیطی که معمولاً نیازی به مشاهدهٔ دادهٔ واقعی ندارد. ردیابی اصالت داده نیز باید منبع و تغییرات داده را در تمام چرخه دنبال کند. امضای رمزنگاری، دفتر ثبت تغییرات غیرقابلتغییر، checksum و hash میتوانند دستکاری در ذخیرهسازی و انتقال را آشکار کنند.
طبقهبندی و حکمرانی داده تعیین میکند هر داده به چه سطحی از حفاظت نیاز دارد و چه دسترسیای باید بر آن اعمال شود. خروجی سامانه نیز باید دستکم در همان سطح دادهٔ ورودی طبقهبندی شود. حفاظت باید جمعآوری، پیشپردازش، آموزش و استنتاج را یکجا ببیند.
امنیت خود مدل
مدل یک دارایی مستقل است و باید یکپارچگی آن تأیید شود. رمزنگاری و امضای دیجیتال مدل و مصنوعات مرتبط میتواند تغییر غیرمجاز را آشکار کند. آموزش خصمانه نیز با واردکردن نمونههای خصمانه در چرخهٔ آموزش، مقاومت مدل را در برابر حملات مشابه افزایش میدهد. نقاط پایانی مدل باید کنترل دسترسی سختگیرانه داشته باشند تا استفادهٔ غیرمجاز و استخراج مدل محدود شود.
فایل مدل هنگام ورود به سازمان یا دانلود نیز باید مشکوک فرض شود. پاکسازی و بازسازی محتوا میتواند فرآیند بازکردن امن بسته را به توابع و آرگومانهای مجاز محدود کند و مدل بازسازیشده را در قالبی مانند SafeTensors ذخیره کند؛ قالبی که برای جلوگیری از اجرای کد دلخواه در هنگام بارگذاری طراحی شده است.
در سطح پیشرفتهتر، دفاع هدف متحرک میتواند با تصادفیسازی وزن و جداسازی نگاشت مدل از وزنهای تصادفیشده، استفادهٔ غیرمجاز از فایل مدل را دشوار کند. CDR و MTD نشان میدهند دارایی در هوش مصنوعی فقط داده یا محاسبه نیست؛ ساختار داخلی و یکپارچگی خود مدل نیز به کنترل تخصصی نیاز دارد.
امنیت زیرساخت و عملیات
محیط آموزش، موتور استنتاج و محیط توسعه باید بخشبندی و از یکدیگر ایزوله شوند تا نفوذ به یک جزء به حرکت جانبی در کل سامانه منجر نشود. جریان داده، استفاده از API و تعامل با مدل باید پیوسته پایش شوند و تحلیل رفتار بتواند فعالیت غیرعادی مانند تلاش برای استخراج مدل را تشخیص دهد. Shadow IT و Shadow AI نیز باید در همین دامنهٔ نظارت قرار گیرند.
احراز هویت چندمرحلهای فقط برای انسان نیست؛ کاربر و ماشینِ دسترسییابنده به منابع AI باید هویت قابل راستیآزمایی داشته باشند. احراز هویت تطبیقی میتواند بر اساس دستگاه، مکان و رفتار سطح کنترل را تغییر دهد و هویت در طول نشست دوباره بررسی شود.
اتوماسیون و ارکستراسیون امنیت امکان اعمال سیاست یکپارچه در میکروسرویس، خط لولهٔ داده و اجزای AI را فراهم میکند. موتور سیاستی مانند OPA میتواند تصمیم را از کد هر جزء جدا کند. پاسخ به حادثه، مدیریت آسیبپذیری، پچکردن کتابخانه و وابستگی و آزمونهای امنیتی SAST و DAST نیز باید در خط لولهٔ CI/CD ادغام شوند.
امنیت باید از مرحلهٔ طراحی وارد چرخه شود. مدلسازی تهدید و طراحی امنیتمحور برای شناخت ریسک گردش کار AI ضروریاند و مسئولیت باید میان تیم سازمان و تأمینکننده روشن باشد. بهکارگیری هوش مصنوعی برای تشخیص تهدید و پاسخ خودکار نیز میتواند حلقهای خودتقویتکننده بسازد: هوش مصنوعی برای امنیت هوش مصنوعی.
چالشهای پیادهسازی
ZTAI به تخصص همزمان در امنیت سایبری، یادگیری ماشین، سامانههای توزیعشده و MLOps نیاز دارد و یکپارچهسازی کنترلها در خط لولهٔ موجود ساده نیست. حذف دسترسی مستقیم انسان به دادهٔ خام نیز میتواند با مقاومت دانشمند داده و مهندس روبهرو شود؛ چون نقش آنها از مداخلهٔ مستقیم به تعریف سیاست و نظارت تغییر میکند.
زیرساخت ایزوله، رمزنگاری پیشرفته و نظارت مستمر هزینهٔ اولیه دارند. به همین دلیل پیادهسازی باید مرحلهای و بر اساس مدل بلوغ انجام شود تا سرمایهگذاری با اولویت و ریسک سازمان متناسب باشد. مدلها و فرآیندهای قدیمی نیز به راهبرد مهاجرت نیاز دارند و ممکن است خط لولهٔ داده و مدل برای انطباق با اصول بدون اعتماد بازسازی شود.
هوش مصنوعی بدون اعتماد محصول یک خرید یا تنظیم امنیتی نیست. نتیجهٔ کنارهمقرارگرفتن سیاست، معماری، بلوغ مهندسی، خودکارسازی و شواهد قابل ممیزی است. هرجا یکی از این اجزا غایب باشد، عبارت «بدون اعتماد» ممکن است فقط نام تازهای برای همان امنیت محیطی قدیمی باشد.
کنترل مسیرهای غیرمستقیم دسترسی به دادهٔ محرمانه؛ از اختیار تغییر کد تا خروج اطلاعات و مدیریت زیرساخت.
مطالعهٔ فصل: وقتی انسان داده را نمیبیند؛ آیا واقعاً دسترسی او حذف شده است؟
سازمانی را تصور کنیم که برای توسعهٔ یک مدل هوش مصنوعی، دادههای حساس خود را در محیطی جدا نگه داشته است. تیم توسعه به پایگاه داده دسترسی ندارد، فایلهای واقعی روی رایانهٔ کارشناسان کپی نمیشوند و آموزش از طریق یک خط لولهٔ خودکار انجام میشود. در نگاه نخست، مسئله حل شده است: انسان داده را نمیبیند و ماشین کار مورد نیاز را انجام میدهد.
اما اگر همان کارشناس بتواند برنامهٔ آموزش را تغییر دهد و چند سطر از داده را در گزارش خطا قرار دهد، چه اتفاقی افتاده است؟ اگر اجازهٔ دریافت فایل مدل را داشته باشد، اما مدل اطلاعاتی از دادهٔ آموزش را بازگو کند، مرز محرمانگی کجاست؟ و اگر مدیر زیرساخت بتواند حافظهٔ محیط اجرا را بخواند یا کلید رمزگشایی را به دست آورد، حذف حساب کاربری پایگاه داده چه چیزی را تضمین کرده است؟
در یادداشت «گره کور داده برای هوش مصنوعی؛ به دست باز کنیم یا دندان؟»، تفکیک حق پردازش از دریافت دادهٔ خام مطرح شد. این تفکیک، یک مسئلهٔ معماری نیز دارد: باید بتوان پردازش معینی را مجاز کرد، در حالی که اطلاعات خارج از حدود همان مجوز در اختیار مجری قرار نگیرد. این یادداشت به شرایط فنی چنین تفکیکی میپردازد.
حذف انسان از مسیر داده، یک هدف معماری است
در صورتبندی این مجموعه از هوش مصنوعی بدون اعتماد، یکی از اهداف اصلی آن است که فرایندهای دادهمحور چنان طراحی و خودکار شوند که اجرای روزمرهٔ آنها به مشاهده، جابهجایی و دستکاری مستقیم داده توسط انسان نیاز نداشته باشد. انسان مسئله و حدود استفاده را تعریف میکند، فرایند را میسازد و شواهد عملکرد آن را بررسی میکند؛ دادهٔ حساس در مسیر کنترلشده باقی میماند.
این هدف در سطح چهار مدل بلوغ ZTAI با تفکیک محیط توسعه و تولید توضیح داده شده است. در ادامهٔ همان صورتبندی باید مشخص شود چه اختیاراتی پس از این تفکیک باقی میماند و آیا ترکیب آنها امکان دسترسی به داده را دوباره ایجاد میکند.
این برداشت، هدف معماری مورد بحث در این مجموعه است و نباید آن را عین تعریف یک استاندارد مستقل و مصوب ZTAI تلقی کرد. معماری بدون اعتماد NIST نیز از ابتدا منابع، خدمات و گردش کار را در بر میگیرد. تأکید اینجا بر بازطراحی فرایند برای حذف نیاز به دخالت مستقیم انسان در دادههای حساس و محدودکردن اختیاراتی است که میتوانند این جدایی را بیاثر کنند.
از همین ابتدا باید دامنهٔ ادعا روشن باشد. ممکن است هدف، حذف دسترسی تیم توسعه باشد؛ ممکن است مدیر زیرساخت، پیمانکار نگهداری یا ارائهدهندهٔ ابر نیز در دامنه قرار گیرند. معماری باید برای هرکدام توضیح دهد چه کاری میتوانند انجام دهند، چه اطلاعاتی دریافت میکنند و چه فرضهایی دربارهٔ سختافزار، نرمافزار و تبانی میان نقشها دارد. عبارت کلی «هیچ انسانی دسترسی ندارد» جای چنین توضیحی را نمیگیرد.
حق نوشتن کد میتواند راهی برای خواندن داده باشد
سناریوی آغازین به حملهای پیچیده نیاز ندارد. برنامهای که مجاز است داده را برای آموزش بخواند، از نظر فنی ممکن است بتواند همان داده را در فایلی دیگر بنویسد. اگر صاحب برنامه اختیار تعیین آن فایل و دریافتش را هم داشته باشد، نداشتن مجوز مستقیم پایگاه داده مانع کافی نخواهد بود.
این اتفاق حتی میتواند بدون قصد سوء رخ دهد. توسعهدهنده برای کشف اشکال، نمونهٔ ورودی را همراه خطا ثبت میکند؛ کتابخانهٔ پایش، ورودی و خروجی فراخوانیها را ذخیره میکند؛ یا تنظیم پیشفرض یک ابزار آزمایش، نمونههای داده را به گزارش اضافه میکند. هرکدام از این رفتارها ممکن است در محیط توسعه مفید باشد، اما در محیط محرمانه مسیر افشای اطلاعات بسازد.
حذف مجوز مشاهده، زمانی مؤثر است که ترکیب اختیار تغییر پردازش و دریافت خروجی، همان دسترسی را از مسیری دیگر بازسازی نکند.
در نتیجه، درخواست اجرای یک فرایند باید بیش از نام برنامه یا هویت درخواستکننده را مشخص کند. نسخهٔ کد، دادهٔ مجاز، عملیات، مقصد خروجی، مدت اعتبار و محدودیت منابع، اجزای همان درخواستاند. مجوز اجرای آموزش روی مجموعهای معین، نباید به مجوز اجرای هر برنامهای با هر خروجی روی آن مجموعه تبدیل شود.
امضا و ثبت منشأ کد ضروریاند، اما پاسخ همهٔ مسئله نیستند. امضا نشان میدهد یک بسته با هویت و تمامیت مشخص وارد شده است؛ خوشرفتاری آن را اثبات نمیکند. اسکن امنیتی و بازبینی نیز بخشی از شواهد پذیرشاند. برای کد عمومی و دلخواه، نمیتوان از چند بررسی مقدماتی نتیجه گرفت که همهٔ مسیرهای افشا بسته شدهاند. به همین دلیل، کنترل رفتار هنگام اجرا و کنترل خروج اطلاعات باید پس از پذیرش کد نیز برقرار بمانند.
سه اختیار را از یکدیگر جدا کنیم
تفکیک نقشها فقط به این معنا نیست که نام سه نفر در سه ستون یک جدول نوشته شود. سه اختیار باید در سازوکار اجرا از یکدیگر مستقل باشند: تعریف پردازش، پذیرش آن برای اجرا و اجازهٔ خروج نتیجه.
تیم توسعه میتواند پردازش پیشنهادی را بسازد. مرجع پذیرش، انطباق نسخهٔ مشخص آن با مأموریت، محیط و محدودیتها را بررسی میکند. مرجع خروج نیز تعیین میکند کدام نتیجه، برای چه دریافتکنندهای و با چه سطحی از جزئیات قابل انتشار است. اجرای معمول این تصمیمها میتواند خودکار باشد؛ استقلال آنها مستلزم سه تأیید دستی برای هر کار نیست.
فرایند پردازش نباید بتواند سیاست ناظر بر خودش را تغییر دهد، مقصد تازهای به فهرست خروجیها اضافه کند یا ثبت شواهد را متوقف سازد. به همین ترتیب، فردی که کد پردازش را تغییر میدهد، نباید با همان اختیار بتواند کنترل خروج را نیز کنار بزند. اگر مدیر واحدی همچنان بتواند همهٔ این محدودیتها را تغییر دهد، اعتماد به آن مدیر در معماری باقی مانده و باید صریحاً اعلام شود.
موتور سیاست نیز بخشی از همین مسئله است. استقرار آن در یک سرویس جدا، بهتنهایی استقلال ایجاد نمیکند. اختیار تغییر سیاست، کلید امضا، مسیر انتشار و حساب مدیریتی آن باید بررسی شود. یک کنترل تنها تا جایی مستقل است که جزء تحت کنترل نتواند آن را بازتعریف کند.
بستر این تفکیک، همان نسخهگذاری و تکرارپذیریای است که در MLOps بهعنوان پایهٔ ZTAI مطرح شد. بدون دانستن اینکه کدام نسخهٔ کد، با کدام سیاست، روی کدام داده اجرا شده است، تفکیک اختیار نیز قابل بررسی نخواهد بود.
مرز خروج اطلاعات، از همهٔ خط لولهها عبور میکند
در مدل بلوغ، چهار مرز برای داده، آموزش، ارزیابی و استقرار مطرح شده است. برای تکمیل بحث حاضر، کنترل خروج اطلاعات باید بهصورت یک مرز مشترک بر همهٔ این مراحل اعمال شود. گزارش پاکسازی داده، شاخص ارزیابی و فایل مدل، همگی ممکن است از محیط محرمانه خارج شوند؛ هرکدام به مجوز و قاعدهٔ خروج متناسب نیاز دارند.
بستن اتصال به اینترنت لازم است، اما کافی نیست. اگر گزارش به سامانهٔ داخلی آزمایشها ارسال شود و تیم توسعه آن سامانه را ببیند، داده میتواند همانجا از مرز تعیینشده عبور کند. مرز محرمانگی به مجازبودن دریافتکننده و اطلاعات دریافتی وابسته است؛ داخلیبودن مقصد بهتنهایی آن را تعیین نمیکند.
مسیر خروج
اطلاعاتی که ممکن است آشکار شود
کنترل متناسب
گزارش خطا و لاگ
ورودی واقعی، شناسه یا محتوای یک رکورد
قالب محدود، حذف محتوای حساس پیش از ثبت و محدودیت دسترسی
فایل موقت و خروجی عیبیابی
بخشهایی از داده یا حافظهٔ پردازش
نگهداری در همان مرز و جلوگیری از دریافت خودکار
شاخص و گزارش آماری
ویژگی فرد، گروه کوچک یا وضعیت حساس سازمان
محدودیت جزئیات، بررسی ترکیب خروجیها و کنترل درخواستهای تکراری
وزن، آداپتر و checkpoint
اطلاعات قابل استخراج از مدل یا دادهٔ عمداً درجشده در فایل
کنترل ساختار، آزمون افشا و مجوز مستقل خروج مدل
بردار و نمایهٔ بازیابی
اطلاعات مشتقشده از اسناد حساس
حفظ طبقهبندی و مجوز منبع، تفکیک کاربران و کنترل دریافت
دادهٔ مصنوعی
بازتولید یا استنباط اطلاعات مجموعهٔ اصلی
ارزیابی روش تولید و خطر افشا؛ کنترل انتشار
نسخهٔ پشتیبان و snapshot
کپی داده، رازها یا حافظهٔ ثبتشده
رمزنگاری، تفکیک کلید و اعمال سیاست در بازیابی
خطر این مسیرها یکسان نیست و وجود هرکدام نیز به معنی وقوع افشا نیست. کارکرد جدول، کاملکردن مدل تهدید است. حذف نام اشخاص یا تبدیل داده به قالبی دیگر، بهتنهایی مجوز عبور از مرز نخواهد بود.
در یک طراحی محافظهکارانه، محیط اجرا نمیتواند فایل دلخواهی را برای دریافتکننده ارسال کند. نتیجه باید در قالب تعریفشده به جزء مستقلی تحویل شود که اختیار انتشار دارد. این جزء میتواند نوع و اندازهٔ خروجی، دامنهٔ مقادیر، جزئیات قابل انتشار و سابقهٔ درخواستها را بررسی کند. هرچه آزادی پردازش و تنوع خروجی بیشتر شود، اثبات کفایت این کنترل دشوارتر خواهد شد.
خود جزء کنترل خروج نیز با اطلاعاتی روبهروست که هنوز مجاز به انتشار نشدهاند؛ بنابراین محیط اجرای آن و ارتباطش با پردازشگر باید متناسب با همان حساسیت حفاظت شوند. انتقال دادهٔ رمزگشاییشده از محیط محرمانه به یک فیلتر بیرونی که مدیر میزبان میتواند آن را ببیند، هدف حفاظت را نقض میکند.
فیلتر واژه، عبارت منظم یا یک مدل تشخیص دادهٔ حساس، تنها بخشی از کنترل است. کد میتواند داده را به شکل عدد، قطعههای کوچک یا محتوایی با ظاهر بیخطر در خروجی قرار دهد. به همین دلیل، برای دادههای بسیار حساس باید آزادی تولید خروجی نیز محدود شود؛ گاهی راه مناسب، ارائهٔ مجموعهای از عملیات ازپیشتعریفشده بهجای پذیرش کد دلخواه است.
خروج مدل، تصمیمی جدا از آموزش مدل است
مجوز آموزش روی دادهٔ محرمانه، بهخودیخود دربارهٔ دریافت فایل وزن تصمیم نمیگیرد. ممکن است سازمان اجازه دهد مدل آموزشدیده در همان محیط بهصورت سرویس استفاده شود، اما خروج فایل آن را مجاز نداند. این محدودیت نیز باید با کنترل پاسخهای سرویس همراه باشد؛ ماندن وزنها در محیط، خطر افشا از پاسخها را خودکار برطرف نمیکند.
دو خطر باید تفکیک شوند. در خطر نخست، یک برنامهٔ نامطمئن، اطلاعات را عمداً در فایل خروجی قرار میدهد. در خطر دوم، حتی اجرای درست آموزش نیز ممکن است مدلی بسازد که اطلاعاتی از نمونههای آموزش را حفظ کرده باشد و در شرایطی آشکار کند. کنترل قالب فایل، خطر نخست را فقط تا حدودی محدود میکند؛ ارزیابی رفتار مدل نیز به مسئلهٔ دوم میپردازد.
پروژهٔ SACRO-ML برای بررسی خطر افشای مدلهای آموزشدیده در محیطهای پژوهشی حفاظتشده، ابزارهایی پیش و پس از آموزش ارائه میکند. ارزش این رویکرد، افزودن شواهد افشا به تصمیم انتشار است. بااینحال، موفقنبودن حملههای آزمایششده را نباید تضمین ریاضی عدم افشا دانست یا پوشش یک ابزار را به همهٔ معماریهای مدل تعمیم داد.
همین دقت دربارهٔ دادهٔ مصنوعی لازم است. دادهای که از مجموعهٔ حساس تولید شده، ممکن است اطلاعات همان مجموعه را آشکار کند. راهنمای NIST دربارهٔ ارزیابی تضمینهای حریم خصوصی تفاضلی، منتشرشده در مارس ۲۰۲۵، این محدودیت را صریحاً بررسی میکند. در کاربرد مناسب، حریم خصوصی تفاضلی میتواند اثر حضور یک فرد یا واحد تعریفشده را در نتایج محدود کند؛ تضمین آن به تعریف واحد حفاظت، پارامترها و پیادهسازی وابسته است و همهٔ اسرار عملیاتی سازمان را پوشش نمیدهد.
نتیجههای کوچک هم میتوانند اطلاعات بزرگی بدهند
کنترل خروج نباید هر درخواست را جدا از گذشته بررسی کند. برای مثال، اگر دو گزارش دقیق و مجاز، مجموع یک مقدار را برای دو گروه با اختلاف تنها یک عضو نشان دهند، تفاضل آنها میتواند مقدار مربوط به همان عضو را آشکار کند. در چنین حالتی، هیچ گزارش منفردی الزاماً نام یا رکورد خام نداشته است.
از اینرو، مجوز به یک خروجی منفرد محدود نمیشود؛ سابقهٔ درخواست، همپوشانی گروهها، تعداد تکرار و ترکیب اطلاعات نیز اهمیت دارد. حداقل اندازهٔ گروه و محدودیت تعداد درخواست میتوانند بخشی از دفاع باشند، اما تضمین عمومی ایجاد نمیکنند. در روشهای مبتنی بر حریم خصوصی تفاضلی نیز باید بودجهٔ حریم خصوصی در مجموع انتشارها محاسبه شود، نه اینکه برای هر درخواست از ابتدا آغاز شود. NIST SP 800-226
این مسئله یک پیام معماری دارد: جزء صادرکنندهٔ نتیجه باید به اطلاعات لازم برای ارزیابی درخواستهای مرتبط دسترسی داشته باشد. اگر هر اجرای کوتاهعمر، سیاست را بدون اطلاع از اجراهای پیشین اعمال کند، محدودیتی که در یک اجرا برقرار بوده ممکن است در مجموعهٔ اجراها بیاثر شود.
اگر مدیر زیرساخت هم نباید داده را ببیند
با حذف دسترسی تیم توسعه، هنوز مسئلهٔ مدیر میزبان باقی میماند. در بسیاری از معماریهای متعارف، کسی که اختیار کافی بر سیستمعامل یا لایهٔ مجازیسازی دارد، میتواند بر فرایند و حافظهٔ آن اثر بگذارد. رمزنگاری دیسک نیز بهتنهایی این مسئله را حل نمیکند؛ داده برای پردازش معمول باید در جایی رمزگشایی شود.
همانگونه که در «کانتینر، مرز امنیتی مستقل نیست» توضیح داده شد، جداسازی برنامه از محیط توسعه با حفاظت از آن در برابر مدیر میزبان یکسان نیست. اگر مدیر زیرساخت در مدل تهدید قرار گرفته باشد، انتخاب محیط اجرا باید این فرض را پشتیبانی کند.
پردازش محرمانه یا Confidential Computing، با استفاده از محیط اجرای مورد اعتماد یا TEE، میتواند بخشی از این حفاظت را با پشتوانهٔ سختافزار فراهم کند. الگوی کلی آن چنین است: داده و مدل رمزشده باقی میمانند؛ شواهد محیط اجرا ارزیابی میشود؛ و کلید فقط در اختیار محیطی قرار میگیرد که با سیاست پذیرش تطبیق دارد. راهنمای NVIDIA، بهروزشده در مهٔ ۲۰۲۶، ترکیب محیطهای محرمانهٔ CPU و GPU، گواهیسنجی و آزادسازی مشروط کلید را تشریح میکند.
این فناوری دامنهٔ اعتماد را تغییر میدهد و باید با حدود واقعی خود توصیف شود. حفاظت در برابر مدیر میزبان، لزوماً مدیر داخل ماشین مهمان یا برنامهٔ مجازِ درون محیط را محدود نمیکند. آسیبپذیری سختافزار و نرمافزار، حملههای جانبی و امکان قطع سرویس نیز باید متناسب با فناوری انتخابشده بررسی شوند. هیچیک از این موارد با نوشتن نام TEE در نمودار حل نمیشود.
در بار کاری هوش مصنوعی، مرز حفاظت ممکن است از حافظهٔ CPU تا حافظهٔ GPU و مسیر انتقال میان آنها امتداد پیدا کند. پشتیبانی یک تراشه کافی نیست؛ سرور، firmware، درایور و شیوهٔ استقرار نیز باید سازگار باشند. پیوند این بحث با امنیت زیرساخت هوش مصنوعی از کرنل تا GPU دقیقاً در همین زنجیره است.
گواهیسنجی باید به تصمیم اجرایی متصل شود
گواهیسنجی محیط اجرا یا Attestation، زمانی به محدودکردن دسترسی کمک میکند که نتیجهٔ آن در تصمیمی مؤثر مصرف شود: برای نمونه، تحویلدادن یا ندادن کلید به یک اجرای مشخص. دریافت گزارشی که صرفاً بایگانی میشود، مانع استفاده از محیط نامعتبر نخواهد شد.
الگوی مفهومی: کد، محیط اجرا، کلید و خروجی هرکدام شرط پذیرش دارند. کنترل خروج باید همهٔ مسیرهای دریافت نتیجه، از گزارش تا مدل را پوشش دهد.
در طراحی پیشنهادی، شواهد باید به محیط و اجرای موردنظر مربوط باشند و اعتبار زمانی آنها بررسی شود. سیاست باید مشخص کند چه اندازهگیریهایی پذیرفتنیاند و کلید به کدام هویت و کانال حفاظتشده تحویل میشود. تغییر مرجع پذیرش نیز باید تحت کنترل باشد؛ در غیر این صورت، همان کسی که محیط را تغییر داده میتواند وضعیت جدید را معتبر اعلام کند.
پس از تحویل کلید نیز حفاظت لازم است. اگر فرایند بتواند کد تازهای بارگذاری کند، فایلهای مجاز را تغییر دهد یا کلید را به بیرون بفرستد، پذیرش وضعیت آغازین کافی نخواهد بود. از سوی دیگر، قطع تحویل کلیدهای بعدی لزوماً کلیدی را که قبلاً تحویل شده یا دادهای را که رمزگشایی شده از بین نمیبرد. سیاست خاتمهٔ اجرا، عمر اعتبارنامهها و پاکسازی باید با این واقعیت سازگار باشد.
دامنهٔ گواهیسنجی نیز محدود است: اندازهگیری یک جزء، صحت معنایی همهٔ پردازشها را اثبات نمیکند. این تمایز ادامهٔ بحث «ثباتی که قابل اثبات و بازگشت نیست، امنیت نیست» است؛ شواهد معتبر باید با وضعیت مرجع، تصمیم اعمال سیاست و امکان واکنش پیوند بخورند.
مسیر تعمیر نباید دسترسی حذفشده را دائمی کند
در بسیاری از سامانهها، استثناهای نگهداری از مسیر معمول قدرتمندترند. دسترسی موقت برای رفع اشکال باز میشود، snapshot برای بررسی به محیط دیگری منتقل میشود یا فایل حافظه در اختیار پیمانکار قرار میگیرد. پس از حل مشکل نیز ممکن است بخشی از این دسترسی باقی بماند.
برای معماریای که حذف دسترسی انسان را دنبال میکند، عیبیابی باید از ابتدا طراحی شود: گزارشهای ساختاریافته و محدود، بازتولید خطا با دادهٔ آزمایشی، اجرای آزمون تشخیصی در همان مرز و بازیابی از نسخهٔ معتبر. نیاز به تعمیر نباید خودکار به تحویل دادهٔ خام تبدیل شود.
اگر در موردی مشاهدهٔ انسانی ضروری شد، آن رویداد باید استثنایی واقعی و محدود باشد: برای چه مسئلهای، توسط چه کسی، با دسترسی به کدام داده و تا چه زمانی. بعد از پایان نیز بازگرداندن محدودیتها و بررسی آثار دسترسی لازم است. ثبت چنین موردی از ادعای حذف کامل دسترسی صادقانهتر است و امکان کاهش استثناهای بعدی را فراهم میکند.
خودکارسازی همچنین باید بتواند در وضعیت نامعتبر متوقف شود. سامانهای که برای حفظ تداوم کار، هنگام اختلال کنترل خروج را غیرفعال میکند یا به مسیری با حفاظت کمتر میرود، حدود دسترسی خود را در همان لحظهٔ حساس کنار گذاشته است. برای مأموریتهای نیازمند تداوم، مسیر جایگزین باید از پیش با حدود حفاظت مشخص طراحی و آزموده شود.
چه شواهدی نشان میدهد دسترسی واقعاً محدود شده است؟
ادعای معماری را باید بتوان به پرسشهای قابل آزمون تبدیل کرد. صرف نبودن حساب انسانی در پایگاه داده، همهٔ مسیرهای دسترسی را پوشش نمیدهد. در ممیزی، باید اختیارات قابل ترکیب و خروجیهای قابل دریافت نیز بررسی شوند.
پرسش ممیزی
شاهد مورد انتظار
نتیجهای که بهتنهایی کافی نیست
آیا توسعهدهنده میتواند کد دلخواه را روی داده اجرا کند؟
پذیرش نسخهٔ مشخص، محدودیت اجرا و آزمون تلاش برای دورزدن آن
وجود مخزن Git یا امضای بسته
آیا نتیجه میتواند از مسیر دیگری خارج شود؟
فهرست مسیرهای خروج و آزمون کنترل گزارش، فایل و ارتباطات
بستهبودن اینترنت
آیا پردازشگر میتواند محدودیت خود را تغییر دهد؟
تفکیک اختیار سیاست، کلید و انتشار از محیط پردازش
استقرار موتور سیاست در یک سرویس جدا
آیا مدیر میزبان قادر به مشاهدهٔ داده است؟
مدل تهدید و شواهد پیکربندی حفاظتِ متناسب با آن
رمزنگاری دیسک یا اجرای کانتینری
آیا خروجیهای تکراری محدودیت را بیاثر میکنند؟
بررسی درخواستهای مرتبط و حسابداری تجمعیِ متناسب
پذیرش جداگانهٔ هر خروجی
آیا عیبیابی راه دائمی تازهای ایجاد کرده است؟
سابقهٔ استثنا، انقضا و تأیید بازگشت کنترلها
ثبت درخواست پشتیبانی
این آزمونها دامنه و محدودیت دارند. قبولی در مجموعهای از آزمونها، شواهدی دربارهٔ همان سناریوها فراهم میکند؛ اثبات بستهبودن همهٔ حملههای ممکن نیست. حتی زمان اجرا، اندازهٔ خروجی و الگوی خطا میتوانند در مدلهای تهدید سختگیرانه بهعنوان کانال انتقال اطلاعات بررسی شوند. سطح ادعا باید با آنچه واقعاً طراحی و آزموده شده متناسب بماند.
دو شاخص نیز باید جداگانه دنبال شوند: میزان خودکارشدن فرایند و میزان کاهش دسترسی انسانی. ممکن است خط لولهای کاملاً خودکار باشد، اما افراد متعددی بتوانند داده، حافظه یا خروجی نامحدود آن را دریافت کنند. شمار مسیرهای دسترسی مستقیم و غیرمستقیم، اختیارات مدیریتیِ قادر به دورزدن کنترل و دفعات استفاده از استثنا، در کنار شاخصهای خودکارسازی معنا پیدا میکنند.
امکان استفاده از داده را حفظ کنیم
هدف این معماری، فراهمکردن امکان استفادهٔ مجاز از داده است. اگر تنها راه حفاظت، تعطیلکردن همهٔ پردازشها باشد، مسئلهٔ توسعه حل نشده است. در مقابل، اگر هر نیاز توسعه با اعطای دسترسی تازه برطرف شود، حذف انسان از مسیر داده نیز دوام نمیآورد. کیفیت ابزارهای توسعه و عیبیابی، بخشی از امکانپذیری این معماری است.
نمونهٔ عملی نزدیک به این جهتگیری، OpenSAFELY است: کد پژوهش به محل نگهداری داده میرود، دادهٔ آزمایشی برای توسعه فراهم میشود و پژوهشگر نتایج تجمیعی دریافت میکند. دامنهٔ این مثال مشخص است؛ خود پروژه امکان دسترسی مالکان مراکز داده را مستثنا میکند. بنابراین شاهدی برای امکان توسعه بدون دسترسی آزاد پژوهشگر به داده است، نه تحقق همهٔ فرضهای معماری مورد بحث این یادداشت.
در ZTAI، حذف دسترسی انسان زمانی معنای عملی پیدا میکند که مشاهدهٔ مستقیم، اختیار تغییر پردازش، خروج اطلاعات و مدیریت زیرساخت در کنار هم بررسی شوند. انسان همچنان دربارهٔ هدف، حدود اختیار و پذیرش ریسک مسئول است؛ اجرای روزمره باید بتواند در همان حدود، بدون مراجعهٔ مکرر به دادهٔ خام ادامه یابد.
آزمون نهایی فقط این نیست که امروز چه کسی داده را میبیند. باید بتوان نشان داد پس از تغییر کد، هنگام خرابی و در زمان دریافت نتیجه نیز چه کسی میتواند به اطلاعات برسد و کدام کنترل، حدود این امکان را حفظ میکند.
قرارداد داده، توسعه با دادهٔ آزمایشی و ارزیابی مستقل در محیط حفاظتشده.
مطالعهٔ فصل: مهندسی داده و مدل بدون مشاهدهٔ دادهٔ محرمانه
مهندس داده میگوید تا چند نمونه را نبیند، نمیتواند بفهمد چرا تبدیل تاریخ شکست خورده است. دانشمند داده میخواهد خطاهای مدل را کنار ورودیهای واقعی بگذارد. ارزیاب هم میپرسد اگر اجازهٔ دیدن موارد اشتباه را نداشته باشد، چگونه کیفیت را تأیید کند. اینها اعتراضهایی واقعیاند؛ صرفِ ممنوعکردن مشاهدهٔ داده، ابزار لازم برای انجام کار را فراهم نمیکند.
در یادداشت «وقتی انسان داده را نمیبیند؛ آیا واقعاً دسترسی او حذف شده است؟» مسئله این بود که اختیار تغییر کد، دریافت خروجی و ادارهٔ زیرساخت میتواند دسترسی حذفشده را بازسازی کند. اکنون باید سوی دیگر همان مسئله را بررسی کرد: پس از محدودکردن این اختیارات، کار مهندسی چگونه ادامه پیدا میکند؟ معماریای که فقط راههای مشاهده را ببندد، اما راه تشخیص و اصلاح خطا را نسازد، در نخستین بحران با درخواست دسترسی اضطراری روبهرو میشود.
در صورتبندی فرایندمحور این مجموعه از ZTAI، هدف بازطراحی و خودکارسازی فرایندهای دادهمحور برای حذف نیاز به دسترسی و دخالت مستقیم انسان در دادهٔ محرمانه است. انسان همچنان هدف و سیاست را تعیین میکند، روشها را میسازد و شواهد را داوری میکند؛ اجرای روزمره نباید به بازکردن فایل واقعی و دستکاری دستی رکوردها وابسته باشد. این صورتبندی، هدف معماری این مجموعه است، نه نام یک استاندارد مستقل و مصوب با همین تعریف.
پاسخ نیز «بینیازی از شناخت داده» نیست. باید شناخت لازم برای مهندسی را از مشاهدهٔ مصداقهای محرمانه جدا کرد و برای هر مرحله، جایگزین اطلاعاتیِ کافی ساخت. میزان موفقیت این جداسازی به ساختار داده، کیفیت مستندات، وجود برچسب معتبر و نوع مسئله وابسته است.
شناخت داده را از دیدن مصداق جدا کنیم
برای نوشتن یک مبدل، دانستن نوع، معنا، واحد و قواعد اعتبار یک فیلد معمولاً ضروری است؛ دانستن مقدار آن برای مشتری یا دستگاهی مشخص، لزوماً ضروری نیست. برای انتخاب روش برخورد با مقدار گمشده، شناخت الگوی فقدان داده لازم است، اما میتوان آن الگو را با گزارشی کنترلشده شناخت. در مقابل، فهم کنایه در یک مکالمه یا داوری دربارهٔ مرز یک ضایعه در تصویر ممکن است بدون مشاهدهٔ محتوای همان نمونه ممکن نباشد.
از این تمایز، سه سطح شناخت به دست میآید: شناخت ساختار و معنا؛ شناخت توزیع و رفتار جمعی؛ و شناخت مصداق. دو سطح نخست را در بسیاری از مسائل میتوان با قرارداد و شواهد ماشینتولید فراهم کرد. سطح سوم باید یا با یک فرایند معتبر جایگزین شود، یا در دامنهٔ استثناییِ صریح باقی بماند. پنهانکردن این تفاوت، وعدهٔ حذف مشاهده را غیرقابل دفاع میکند.
دامنهٔ حفاظت هم باید روشن باشد. «تیم پیمانکار رکورد خام را نمیبیند» با «هیچ فردی در سازمان، حتی مدیر زیرساخت، امکان مشاهده ندارد» یک ادعا نیست. طرحی که در ادامه میآید، نخست چرخهٔ مهندسی را از مشاهدهٔ مستقیم تیم توسعه مستقل میکند. گسترش آن به مدیر میزبان یا ارائهدهندهٔ زیرساخت، به کنترلهای افزوده و فرضهای صریح نیاز دارد؛ همان موضوعی که مقالهٔ قبلی دربارهٔ آن بحث کرده است. این معماری، روش اجرای استفادهٔ مجاز است و بهخودیخود مجوز تازهای برای پردازش یا تغییر هدف استفاده ایجاد نمیکند.
قرارداد داده؛ چیزی بیشتر از فهرست ستونها
شمای داده یا Schema مشخص میکند چه فیلدهایی با چه نوع و ساختاری وجود دارند. قرارداد داده باید توضیح دهد این فیلدها چه معنایی دارند، چگونه تولید میشوند، چه کیفیتی از آنها انتظار میرود و در صورت نقض انتظار چه اتفاقی میافتد. یک فیلد عددی با نام temperature بدون واحد، محل حسگر و معنای زمان ثبت، برای مهندسی قابل اتکا نیست.
برای نمونه، قرارداد دادهٔ تجهیزات باید میان زمان وقوع و زمان وصول رخداد تفاوت بگذارد؛ محدودهٔ معتبر دما را از محدودهٔ معمول کارکرد جدا کند؛ روشن سازد مقدار صفر اندازهگیری واقعی است یا جانشین دادهٔ مفقود؛ و تعیین کند تغییر شناسه پس از تعمیر، به معنی دستگاه تازه است یا ادامهٔ تاریخچهٔ همان دارایی. رابطهٔ جدولها، کلیدهای پیوند، رفتار دادهٔ دیررس، نسخهٔ کدگذاری دستهها و سیاست اصلاح گذشته نیز جزئی از قراردادند.
قرارداد در این معماری دو وجه دارد. وجه قابل ارائه به توسعهدهنده، ساختار و معنای مجاز را توضیح میدهد. وجه اجرایی در محیط امن، نگاشت منابع واقعی، قواعد کیفیت، مجوز پردازش و سیاست خروج را نگه میدارد. نام یک جدول، فهرست مکانها یا حتی وجود یک دستهٔ خاص ممکن است محرمانه باشد؛ بنابراین فراداده نیز بدون بررسی، عمومی فرض نمیشود.
پروژهٔ Open Data Contract Standard نمونهای از صورتبندی ماشینخوانِ شِما، کیفیت، مسئولیت و سطح خدمت است. در معرفی نسخهٔ ۳٫۱٫۰، رابطهٔ میان فیلدها و زمانبندی بررسی تعهدهای سطح خدمت نیز برجسته شده است. استفاده از چنین قالبی، بهخودیخود کنترل امنیتی را اجرا نمیکند؛ قرارداد باید به آزمون و تصمیم پذیرش متصل شود.
قرارداد از کجا میآید؟ بخش مهمی از مستندات سامانهٔ مبدأ، واژهنامهٔ کسبوکار و دانش مسئول فرایند استخراج میشود؛ بخشی نیز با تحلیل خودکار در مرز امن پیشنهاد میشود. اگر معنای داده فقط با خواندن پروندههای واقعی قابل کشف باشد، مرحلهٔ راهاندازی هنوز به بررسی محدود نیاز دارد. این هزینه را نباید به توسعهدهنده منتقل کرد و همزمان ادعا کرد هیچکس لازم نیست داده را بشناسد.
محیط توسعه به کدام داده نیاز دارد؟
دادهٔ عمومی، دادهٔ آزمایشی و دادهٔ مصنوعیِ آموختهشده از منبع محرمانه، سه چیز متفاوتاند.
دادهٔ عمومی برای آزمودن ابزار، ساخت خط مبنا و بررسی اولیهٔ روش مفید است. اما عمومیبودن، به معنی نمایندگی جامعهٔ هدف، نبود اطلاعات شخصی یا مجازبودن هر استفاده نیست. منشأ و مجوز باید مشخص باشند و فاصلهٔ آن با محیط واقعی سنجیده شود. عملکرد خوب روی یک مجموعهٔ عمومی، کیفیت مدل روی دادهٔ سازمان را تأیید نمیکند.
دادهٔ آزمایشی را میتوان مستقیماً از قرارداد ساخت: زمان نامعتبر، شناسهٔ تکراری، حسگر قطعشده، مقدار خارج از دامنه، ترتیب زمانی بههمخورده و تغییر نسخهٔ پیام. هدف این داده، واقعینمایی کامل نیست؛ پوشش رفتار مورد انتظار و حالتهای شکست است. آزمونهای مولد و مبتنی بر خاصیت نیز میتوانند بررسی کنند که مثلاً جابهجایی ترتیب ورودی نباید حاصل تجمیع را تغییر دهد یا تکرار یک پیام نباید دوباره شمرده شود. این آزمونها بخش بزرگی از اشکالهای خط لوله را پیش از تماس با دادهٔ واقعی پیدا میکنند.
اما دادهٔ مصنوعیای که مولد آن از دادهٔ محرمانه آموخته است، یک خروجی مشتقشده از همان منبع است. نبودِ تطابق عینبهعین با رکوردها کافی نیست: امکان استنباط ویژگی حساس، پیوند با اطلاعات جانبی و تشخیص عضویت باید بررسی شود. پژوهش معرفی Anonymeter نمونهای از ارزیابی حملهمحورِ تکافتادهسازی، پیوندپذیری و استنباط در دادهٔ مصنوعی جدولی است. نتیجهٔ مطلوب در چنین آزمونهایی، شاهد کاهش خطر در سناریوهای آزمودهشده است، نه اثبات نبود هر نوع افشا.
در صورت استفاده از حریم خصوصی تفاضلی، واحد حفاظت، حدود مشارکت هر واحد، پارامترها و حسابداری انتشارهای مرتبط باید مشخص باشند. حفاظت از «یک ردیف» با حفاظت از «یک شخص با هزار ردیف» یکسان نیست. راهنمای نهایی NIST SP 800-226، منتشرشده در ۶ مارس ۲۰۲۵، دقیقاً برای ارزیابی معنای چنین تضمینهایی و خطرهای پیادهسازی آنها تدوین شده است. حریم خصوصی تفاضلی نیز لزوماً اسرار جمعی سازمان، مانند ظرفیت تولید یا الگوی عملیاتی یک مجموعه، را پنهان نمیکند.
خود آمادهسازی داده میتواند بودجه مصرف کند. برای مثال، مستندات SmartNoise توضیح میدهد که برآورد حدود مقادیر از دادهٔ خصوصی، در برخی پیشپردازشها هزینهٔ حریم خصوصی دارد. اگر دامنهها، انتخاب ویژگی یا تنظیم مولد از دادهٔ واقعی تأثیر بگیرند، نمیتوان فقط آخرین مرحلهٔ تولید را بررسی کرد. نمونهگیری دوباره از یک مولدِ واقعاً تفاضلی و ثابت، بدون مراجعهٔ تازه به داده، پسپردازش است؛ بازآموزی مولد یا ارزیابیهای تازه روی منبع، وضعیت دیگری دارد.
تحول تازهتر نیز همین احتیاط را تقویت میکند. پیشچاپ «آیا برای این کار باید از دادهٔ مصنوعی استفاده کنم؟» در ۳ فوریهٔ ۲۰۲۶ کاربردهای اشتراکگذاری و افزایش داده را از هم جدا کرده و محدودیتهای تناسب روش با مسئله را بررسی میکند. برداشت مهندسی برای این بحث روشن است: دادهٔ مصنوعی میتواند رابط توسعه باشد، اما جای آزمون نهایی روی دادهٔ واقعی را نمیگیرد.
پروفایل آماری، یک محصول کنترلشده است
پس از عبور کد از آزمونهای آزمایشی، تیم توسعه به شواهدی از وضعیت واقعی نیاز دارد: نرخ مقادیر مفقود، توزیع مقادیر، میزان تکرار، شکست پیوند جدولها، تغییر رفتار زمانی و نسبت برچسبها. این شواهد باید درون مرز امن محاسبه شوند و نسخهٔ قابل ارائهٔ آنها از دروازهٔ خروج بگذرد.
خروجی مناسب لزوماً فایل کامل یک ابزار پروفایلسازی نیست. چنین فایلی ممکن است نمونهٔ مقادیر، واژههای پرتکرار یا کمینه و بیشینهٔ دقیق را هم داشته باشد. در طراحی پیشنهادی، دستهها و بازههای مجاز تا جای ممکن از قبل تعیین میشوند؛ شناسه و رشتهٔ آزاد به گزارش راه ندارند؛ و گزارش به هدف، دریافتکننده و مجموعهٔ مشخصی از داده متصل است. زمان تولید، نسخهٔ قرارداد، روش محاسبه و اثر حذف یا افزودن نویز نیز باید همراه آن معلوم باشند.
حداقل اندازهٔ گروه، گردکردن و حذف خانههای کمتعداد میتوانند بخشی از کنترل باشند، اما آستانهای مانند «حداقل بیست عضو» تضمین عمومی محرمانگی نیست. تعداد واحدهای مستقل مهم است، نه فقط تعداد ردیفها؛ هزار مشاهده از یک دستگاه، هزار دستگاه محسوب نمیشود. همچنین جمع سطر و ستون یا تفاضل دو گزارش میتواند خانهٔ حذفشده را بازسازی کند. کنترل باید انتشارهای مرتبط را در کنار یکدیگر ببیند، از جمله گزارشهایی که افراد مختلفِ یک پروژه دریافت میکنند.
این محدودیت بر یادگیری نیز اثر دارد. اگر نتیجه با نویز منتشر شده یا برای بعضی زیرگروهها قابل انتشار نیست، توسعهدهنده نباید آن را مقدار دقیق یا شاهد برابری گروهها بخواند. عبارت «شواهد کافی برای گزارش نداریم» باید خروجی معتبر سامانه باشد. پاسخ خالی نباید به معنای صفر تعبیر شود.
تشخیص کیفیت و سوگیری، بدون نمایش رکورد خام
بسیاری از خطاهای کیفیت با قاعده تشخیصپذیرند: نقض نوع، شکست کلید خارجی، ناهماهنگی واحد، وقفهٔ حسگر، شناسهٔ تکراری و اختلاف توزیع آموزش و بهرهبرداری. ابزارهایی مانند TensorFlow Data Validation محاسبهٔ آمار، بررسی انطباق با شِما و تشخیص تغییر توزیع را پشتیبانی میکنند. بااینحال، گزارش پیشفرض ابزار میتواند مقادیر واقعی را نیز نشان دهد؛ این قابلیت، معادل خروجی امن برای توسعهدهنده نیست.
تغییر مهم در فرایند آن است که بهجای «نمایش رکورد خراب»، یک قاعدهٔ نقضشده، دامنهٔ اثر مجاز و آزمون بازتولیدپذیر ارائه شود. موارد مسئلهدار داخل مرز علامتگذاری یا قرنطینه میشوند و اصلاح با یک تبدیل نسخهدار انجام میشود. منبع اولیه حفظ میشود؛ پاکسازی نباید به دستکاری بیردپای گذشته تبدیل شود.
جدول زیر، طراحی پیشنهادی این رابط شواهد است؛ نه تضمین آمادهٔ یک محصول خاص:
پرسش مهندسی
محاسبه در مرز امن
آنچه میتواند با مجوز ارائه شود
محدودیت تعیینکننده
آیا قالب داده تغییر کرده است؟
اعتبارسنجی نوع، فیلد و نسخهٔ پیام
کد خطا و فهرست تغییرات مجاز قرارداد
نام فیلد و دستهٔ جدید هم ممکن است حساس باشد
کدام تبدیل شکست میخورد؟
شمارش نقض قواعد و بازاجرای تشخیصی
شناسهٔ قاعده و نمونهٔ ساختگیِ بازتولیدکننده
نمونهٔ ساختگی نباید بازنویسی قابل شناساییِ یک رکورد باشد
کدام منابع داده ناقصاند؟
فقدان و تأخیر به تفکیک گروه و زمان
نرخهای کنترلشده برای گروههای مجاز
ریزشدن زمان و گروه میتواند منبع حساس را مشخص کند
آیا پیوند جدولها درست است؟
بررسی چندگانگی و رکوردهای بیتطابق
نسبت شکست و نوع رابطهٔ نقضشده
فهرست کلیدهای ناموفق خارج نمیشود
آیا توزیع تغییر کرده است؟
مقایسه با مرجع ثابت و پنجرهٔ تعریفشده
شاخص تغییر همراه روش و عدم قطعیت
تغییر توزیع، بهتنهایی افت کیفیت مدل را ثابت نمیکند
آیا مدل برای گروهی ضعیفتر است؟
خطا و کالیبراسیون روی برچسب مستقل
سنجهٔ گروهی با کفایت نمونه و کنترل افشا
نبود داده یا برچسب معتبر، ادعای نبود سوگیری را ناممکن میکند
آیا اصلاح بهبود داده است؟
مقایسهٔ دو نسخه روی ورودی ثابت
تغییر سنجهها و شمار کنترلشدهٔ موارد متأثر
بهبود یک سنجه ممکن است حاصل حذف موارد دشوار باشد
آیا مدل قابل تحویل است؟
ارزیابی کیفیت و خطر افشای مصنوعات
گزارش پذیرش؛ فایل مدل فقط با مجوز مستقل
کیفیت خوب، مجوز خروج وزن و checkpoint نیست
در موضوع سوگیری، شمارش گروهها کافی نیست. باید ابتدا معلوم شود چه آسیبی مورد نظر است: از دسترفتن خرابی در خانوادهای از تجهیزات، رد نادرست متقاضیان یا کیفیت پایینتر پاسخ برای یک زبان. سپس سنجهٔ مرتبط، گروههای ازپیشتعریفشده و کیفیت برچسب بررسی شوند. مستندات سنجههای انصاف در Fairlearn نیز تأکید میکند که سنجهها فرضهای متفاوت دارند و استفادهٔ رایج، به معنای استفادهٔ درست نیست.
ممکن است ویژگی حساس برای آموزش ممنوع، اما پردازش آن برای ارزیابیِ مجاز لازم باشد. در این حالت، ارزیاب آن ویژگی را در مرز امن مصرف میکند و مدل یا تیم توسعه آن را دریافت نمیکند. اگر جمعآوری یا استفاده از آن مجاز نباشد، باید محدودیت ارزیابی ثبت شود؛ حدسزدن ویژگی از نام و نشانی، جای خالی شاهد معتبر را پر نمیکند.
مهمتر آنکه خطای معنایی همیشه در آمار دیده نمیشود. اگر برچسب تاریخی حاصل یک تصمیم نادرست باشد، مدل ممکن است آن تصمیم را بسیار دقیق بازتولید کند. کشف چنین مسئلهای به دانش حوزه، مرجع مستقل و گاهی مشاهدهٔ محدود نیاز دارد. گزارش آماری میتواند محل پرسش را نشان دهد؛ نمیتواند هر پرسش معنایی را بهجای انسان پاسخ دهد.
چرخهٔ پیشنهادی: توسعهدهنده فرایند را اصلاح میکند، نه رکورد محرمانه را. ارزیاب و دروازهٔ خروج، زیر اختیار کد آموزش نیستند. گزارش خامِ تشخیصی، برچسبها و فایل مدل در مرز امن میمانند؛ فقط شواهد پذیرفتهشده بازمیگردند.
برچسبگذاری و ارزیابی باید از مدل استقلال داشته باشند
در مسائل مناسب، برچسب را میتوان از پیامدهای ثبتشده استخراج کرد: خرابی تأییدشدهٔ تجهیز، برگشت قطعی کالا یا نتیجهٔ نهایی یک فرایند. قاعدهٔ استخراج باید روشن کند پیامد چه زمانی قابل دانستن شده و چه مواردی مبهم یا ناقصاند. «رخدادی ثبت نشده» همیشه به معنی «رخدادی اتفاق نیفتاده» نیست.
برچسبگذاری ضعیف با قواعد یا مدلهای کمکی نیز ممکن است، اما خروجی آن حقیقت مرجع نیست. باید منشأ برچسب، میزان پوشش، تعارض میان قواعد و خطای آن روی نمونهای مستقل سنجیده شود. سپردن برچسبگذاری به مدل زبانی، نیاز به اعتبارسنجی را حذف نمیکند و ارسال داده به یک خدمت بیرونی، خود تصمیم جداگانهٔ دسترسی است.
اگر حقیقت مرجع فقط با مشاهدهٔ متخصص به دست میآید، دو انتخاب صادقانه وجود دارد: تیم مجازِ برچسبگذاری در محیط محدود و جدا از تیم توسعه کار کند؛ یا دامنهٔ پروژه به دادهها و وظایفی محدود شود که بدون آن مشاهده قابل ارزیابیاند. گزینهٔ اول، حذف مشاهدهٔ تیم توسعه است، نه حذف مشاهدهٔ همهٔ انسانها. اگر برچسبگذاری دستی جزء دائمی تولید باشد، باید همانطور در دامنهٔ ادعا ثبت شود؛ نمیتوان آن را استثنای نادر نامید.
ارزیابی مستقل نیز صرفاً یک اسکریپت جدا نیست. تیم توسعه نباید بتواند با همان اختیارِ تغییر مدل، دادهٔ آزمون نهایی، برچسب مرجع یا قاعدهٔ قبولی را عوض کند. ارزیاب باید نسخهٔ مشخص مدل را روی مجموعهٔ کنارگذاشتهشده اجرا کند و گزارش به همان نسخه متصل باشد. پیشپردازشِ آموختنی فقط از بخش آموزش برازش میشود؛ دادهٔ آزمون نباید در انتخاب ویژگی، تنظیم آستانه یا انتخاب نسخه مصرف شده باشد.
توسعه به بازخورد مکرر نیاز دارد؛ آزمون نهایی برای این کار نیست. یک مجموعهٔ اعتبارسنجی با گزارشهای مجاز برای اصلاح تکراری و یک آزمون نهایی با دسترسی محدود لازم است. تکرار درخواست روی آزمون نهایی هم خطر افشا میسازد و هم به بیشبرازش بر آزمون منجر میشود. در مسائل زمانی یا دادههای چندردیفیِ هر شخص و تجهیز، جداسازی تصادفی ردیفها نیز میتواند نتیجه را خوشبینانه کند.
عیبیابی باید داخل مرز طراحی شود
وقتی برنامه روی دادهٔ واقعی شکست میخورد، نخست باید مشخص شود کدام شاهد برای تشخیص لازم است. شناسهٔ اجرا، مرحلهٔ شکست، نسخهٔ وابستگی، نوع خطا و محدودهٔ مجاز مصرف حافظه، اغلب بدون درج ورودی واقعی قابل ثبتاند. لاگ نباید محل ذخیرهٔ خودکار متن درخواست، بردار ویژگی یا نمونهٔ ناموفق باشد.
پس از آن، یک آزمون تشخیصی پذیرفتهشده میتواند در همان مرز اجرا شود. برای نمونه، بررسی کند خطا از طول ورودی است، از یک دستهٔ ناشناخته میآید یا فقط پس از تغییر نسخهٔ پیام رخ میدهد. نتیجه در قالب محدود برمیگردد. اگر لازم باشد، بازتولیدکنندهای با دادهٔ کاملاً ساختگی ساخته میشود که همان خاصیت ساختاریِ شکست را داشته باشد؛ این بازتولیدکننده نیز پیش از خروج بررسی میشود.
گزارش خطا، نام فایل، stack trace و core dump بیخطر فرض نمیشوند. حتی شناسهٔ مبهمِ پایدار میتواند پیوند گزارشهای متعدد را ممکن کند. دادهٔ خام تشخیصی، اگر نگهداری آن ضروری و مجاز باشد، در مرز امن با عمر محدود میماند. در مدل تهدید سختگیرانهتر، زمان اجرا، اندازهٔ نتیجه و نوع توقف نیز مسیر بالقوهٔ انتقال اطلاعاتاند.
آزادیِ «هر کدی را اجرا کن، فقط خروجی را خلاصه کن» با ادعای قوی محرمانگی سازگار نیست. کد نامطمئن میتواند اطلاعات را در عدد یا وضعیت خطا رمز کند. برای کارهای حساس، عملیات تشخیصی محدود و ازپیشپذیرفتهشده، ارزیاب مستقل و کنترل انتشار لازماند. امضای کد، هویت و تمامیت آن را روشن میکند؛ بیخطر بودن رفتار را اثبات نمیکند.
مشاهدهٔ انسانی، استثنایی با مرز روشن
اگر راههای غیرمشاهدهای برای یک مورد معین کافی نبودند، درخواست مشاهده باید سؤال مشخص داشته باشد: چه ابهامی با کدام بخش داده رفع میشود و چرا شاهد جایگزین کافی نیست؟ مجوز به شخص، هدف، محدودهٔ داده و زمان محدود میشود؛ دسترسی مرحلهای به کوچکترین بخش لازم میرسد و تأییدکننده از درخواستکننده مستقل میماند.
مشاهده در محیط محدود، بدون امکان عادیِ دانلود و انتقال، خطر را کاهش میدهد؛ اما چشم انسان کانال برگشتناپذیر است. انقضای نشست، آنچه فرد دیده یا به خاطر سپرده را پاک نمیکند. به همین دلیل، باید هم اصل ضرورت مشاهده پذیرفته شود و هم ادعای حفاظت برای همان رویداد محدود گردد. ضبط جلسه نیز اگر محتوای حساس را ثبت کند، یک دارایی محرمانهٔ تازه میسازد.
پس از پایان، لغو دسترسی، بررسی آثار خروج، ثبت علت و تولید آزمون بازگشتی لازم است. معیار بهبود فقط کاهش زمان تعمیر نیست؛ باید دید آیا همان علت دوباره به مشاهده نیاز پیدا میکند. تکرار استثنا برای یک نوع خطا، نشانهٔ نقص ابزار مهندسی یا قرارداد داده است.
یک سناریوی کامل: پیشبینی خرابی تجهیزات صنعتی
فرض کنیم بهرهبردار میخواهد احتمال خرابی تأییدشدهٔ یک پمپ را در هفت روز آینده برآورد کند. سابقهٔ حسگرها و تعمیرات، زمان توقف و شناسهٔ دارایی محرمانهاند. هدف، هشدار کمکی برای برنامهریزی بازرسی است، نه فرمان خودکار به تجهیز. تمام تعدادها و حدود این سناریو، فرض طراحی برای توضیح فرایندند؛ نتیجهٔ یک پروژهٔ اجراشده یا آستانهٔ عمومی پذیرش نیستند.
از تعریف مسئله تا بستهٔ توسعه
دادهٔ فرضی شامل ۲۴ ماه سابقهٔ ۲۴۰ پمپ است. بهرهبردار معنای خرابی، تعمیر پیشگیرانه، زمان تأیید و دورهٔ نبود مشاهده را مشخص میکند. دما، لرزش و ساعات کار با واحد و تناوب ثبت معلوم وارد قرارداد میشوند. شناسهها فقط داخل محیط امن پیوند میخورند و از ورودی مدل، متن آزادِ گزارش تعمیر و نشانی واقعی سایت کنار گذاشته میشود. حذف این فیلدها با یک تبدیل نسخهدار انجام میشود، نه انتخاب دستی فایلها.
تیم توسعه قراردادِ قابل ارائه، دادهٔ ساختگی و آزمونهای نمونه را دریافت میکند. در این داده عمداً پیام دیررس، تعویض حسگر، قطعی ثبت، شناسهٔ تکراری و تغییر واحد وجود دارد. استخراج ویژگی از ۲۴ ساعت گذشته و رفتار سامانه در نبود داده آزموده میشود. آنچه در این مرحله تأیید میشود، صحت مکانیکی خط لوله است؛ هنوز هیچ ادعایی دربارهٔ قدرت پیشبینی مطرح نیست.
اجرای واقعی و ساخت برچسب
بستهٔ نسخهدار پس از پذیرش در محیط امن اجرا میشود. مجوز آن فقط منابع، بازهٔ زمانی و عملیات مصوب را پوشش میدهد؛ نه اینترنت آزاد، نصب وابستگی هنگام اجرا یا نوشتن فایل قابل دریافت توسط توسعهدهنده. مدل تهدید این نمونه، مشاهدهٔ تیم توسعه و پشتیبان پیمانکار را منع میکند. اگر منع مدیر میزبان هم شرط قرارداد باشد، محیط اجرا و تحویل کلید باید جداگانه برای آن تجهیز و آزموده شوند.
خط لوله، ورودی را اعتبارسنجی و موارد ناسازگار را قرنطینه میکند. گزارش مجاز ممکن است نشان دهد پس از یک نسخهٔ مشخص پیام، نقض واحد افزایش یافته است؛ اما مقدار و نام دارایی را نمیفرستد. تیم توسعه تبدیل را اصلاح میکند و دو نسخه روی همان snapshot داخلی مقایسه میشوند. کاهش خطا همراه با شمار موارد حذفشده بررسی میشود تا «حل مشکل با کنارگذاشتن دادهٔ دشوار» پنهان نماند.
برچسب مثبت از خرابی تأییدشده در هفت روز پس از زمان پیشبینی ساخته میشود. نمونهٔ منفی فقط وقتی معتبر است که پیگیری آن بازه کامل باشد. پایان سابقه، خروج تجهیز از خدمت یا فقدان ثبت، خودکار منفی نمیشوند. تعمیر پیشگیرانه نیز خرابی نیست و چون میتواند مانع مشاهدهٔ خرابی آینده شود، با سیاست جداگانه مدیریت میشود. فیلدهایی که بعد از زمان پیشبینی تولید شدهاند، مانند نتیجهٔ تعمیر، به ویژگیها راه نمییابند.
آموزش، اعتبارسنجی و آزمون مستقل
تقسیم فرضی، چهارده ماه نخست برای آموزش، چهار ماه بعد برای اعتبارسنجی و شش ماه آخر برای آزمون نهایی است. نمونههایی که پنجرهٔ ویژگی یا پیامدشان از مرز تقسیم عبور میکند حذف میشوند تا اطلاعات آینده به گذشته نشت نکند. قواعد پاکسازی، مقیاسبندی و انتخاب ویژگی روی آموزش برازش میشوند. این آزمون، پیشبینی آینده برای ناوگان موجود را میسنجد؛ ادعای تعمیم به سایت یا خانوادهٔ تجهیز جدید، آزمون جداگانه با کنارگذاشتن آن گروه میخواهد.
یک خط مبنای ساده، مانند قاعدهٔ مصوب بر دما و لرزش، کنار مدل یادگیری ماشین اجرا میشود. تنظیم مدل و آستانه با اعتبارسنجی انجام میشود و سپس نسخهٔ نهایی قفل میشود. ارزیاب مستقل، هم صحت اتصال پیشبینی به زمان و دارایی را بررسی میکند و هم سنجهها را با کد مورد پذیرش محاسبه میکند؛ اعتماد به عددی که خود برنامهٔ آموزش اعلام کرده کافی نیست.
معیار عملیاتی باید از «دقت کلی» دقیقتر باشد. در این نمونه میتوان هدف آزمایشیِ کشف دستکم ۷۰ درصد رخدادهای واجد شرایط، با حداکثر یک هشدار کاذب به ازای هر صد روزِ تجهیزِ تحت پایش را پیشنهاد کرد. بهرهبردار باید این حدود را با هزینهٔ بازرسی و خرابی بپذیرد. هشدارها در هر تجهیز با قاعدهٔ ثابتِ وقفهٔ هفتروزه از هم تفکیک میشوند؛ هر هشدار فقط با نخستین خرابی تأییدشدهٔ بعدی در همان هفت روز تطبیق مییابد و هر رخدادِ کشفشده فقط یکبار شمرده میشود. هشدارِ بدون چنین رخدادی، در صورت پیگیری کامل، کاذب محسوب میشود. زمان توقف و بازگشت از تعمیر نیز با قاعدهٔ ثابت در تعیین واجد شرایط بودن لحاظ میشود. مخرجها فقط زمانها و رخدادهای واجد شرایطِ تعریفشده در قراردادند.
زمان پیشآگاهی، سهم زمانهایی که مدل بهعلت دادهٔ ناکافی پاسخ نداده و تفاوت عملکرد خانوادههای تجهیز نیز گزارش میشوند. برای برآورد عدم قطعیت باید وابستگی مشاهدات تکراری یک تجهیز لحاظ شود؛ میلیونها ردیف حسگر، میلیونها آزمون مستقل نیستند. اگر رخداد کافی وجود نداشته باشد، نتیجه «شواهد ناکافی برای پذیرش» است، حتی اگر برآورد نقطهای از آستانه بالاتر باشد.
تحویل و نگهداری، بدون بازشدن مسیر داده
خروجی تحویل، در این طراحی یک سرویس داخل مرز امن است؛ وزنها، checkpoint و نگاشت شناسهها خارج نمیشوند. پیمانکار گزارشهای مجاز کیفیت و سلامت خدمت را میبیند. کاربران عملیاتیِ مجاز، هشدار مربوط به داراییهای حوزهٔ مسئولیت خود را دریافت میکنند. این مشاهدهٔ کاربردی را نباید با دسترسی تیم توسعه یکی گرفت: گیرنده، هدف و جزئیات خروجی متفاوتاند و هرکدام مجوز مستقل دارند.
استقرار ابتدا در حالت سایه انجام میشود: مدل پیشبینی میکند، اما برنامهٔ تعمیر را تغییر نمیدهد. پس از کفایت شواهد، استفادهٔ کمکی آغاز میشود. از آن لحظه، اقدام تعمیراتی میتواند پیامد آینده را تغییر دهد؛ بنابراین «خراب نشد» لزوماً شاهد کاذببودن هشدار نیست. رویداد اقدام و علت آن باید ثبت و در ارزیابی بعدی لحاظ شوند.
اگر نسخهٔ تازهٔ پیام حسگر باعث شکست شود، مدل برای دادهٔ نامعتبر پاسخ نمیدهد، هشدار سلامت خدمت صادر میشود و مسیر جایگزینِ ازپیشپذیرفتهشده فعال میماند. تیم پشتیبان آزمون تشخیصی را در همان محیط اجرا میکند. بازآموزی نیز تنها وقتی پیش میرود که قرارداد، کیفیت داده، بودجهٔ منابع و قواعد پذیرش برقرار باشند. سابقهٔ نسخهها و امکان بازگشت، بخشی از تحویلاند.
این سناریو کجا ممکن است متوقف شود؟
اگر خرابیها فقط در متنهای آزاد و مبهم ثبت شده باشند، ساخت حقیقت مرجع میتواند به بازبینی متخصص نیاز پیدا کند. اگر حسگرها کالیبره نباشند، دیدن داده یا ندیدن آن مشکل اندازهگیری را حل نمیکند. اگر تعداد خرابی کم باشد، محدودیت آماری با ساخت میلیونها ردیف مصنوعی برطرف نمیشود. اگر الگوی هر سایت بهتنهایی محرمانه باشد، ممکن است حتی سنجهٔ گروهیِ مفید برای پیمانکار قابل ارائه نباشد.
در چنین وضعی باید دامنهٔ مدل، خروجی مجاز، مرحلهٔ آمادهسازی یا روش همکاری بازطراحی شود. گاهی نتیجهٔ درست، توقف آموزش تا اصلاح ثبت داده است. حذف مشاهدهٔ انسانی، جای بلوغ داده و شناخت مسئله را نمیگیرد.
آنچه تجربهٔ عملی تأیید میکند؛ و آنچه نمیکند
در OpenSAFELY، کد به محیط داده میرود و خروجی پژوهش از فرایند بررسی افشا عبور میکند. بررسیکنندگان خروجی نیز طبق توضیح پروژه، دسترسی مستقیم به دادهٔ خام ندارند. این نمونه نشان میدهد پژوهش بدون دسترسی آزاد پژوهشگر به رکوردها، صرفاً طرحی روی کاغذ نیست. در عین حال، بررسی خروجی انسانی است و دامنهٔ دسترسی متولیان زیرساخت را نباید با دسترسی پژوهشگر یکسان فرض کرد.
محدودیت روز این مثال اهمیت بیشتری دارد: سیاست روشهای تحلیلی، بهروزشده در ۲۴ ژوئیهٔ ۲۰۲۶، روشهایی مانند شبکههای عصبی، جنگل تصادفی، گرادیانبوستینگ و مدلهای زبانی را در فهرست روشهای پشتیبانینشدهٔ بررسی افشا قرار میدهد. اجرای آنها بدون مجوز استثناییِ قبلی مجاز نیست، حتی اگر قرار نباشد فایل مدل خارج شود. این محدودیت را نمیتوان به ناممکنبودن ریاضی این روشها تعمیم داد؛ سیاست، ظرفیت محاسباتی، امکان بررسی خروجی و خطرهای حریم خصوصی را نیز در نظر میگیرد. اما نمیتوان OpenSAFELY را شاهد آمادهبودن هر نوع آموزش محرمانه معرفی کرد.
این تجربه با منطق یادداشت سازگار است: امکان اجرای پردازش، امکان ارزیابی نتیجه و امکان انتشار خروجی، سه تصمیم مستقلاند. طراحی چرخه باید از ابتدا با خروجی مورد نیاز قرارداد هماهنگ باشد. آموزش مدلی که بناست به بیرون تحویل شود، بدون داشتن مسیر قابل دفاع برای خروج آن، میتواند پروژه را در آخرین مرحله متوقف کند.
معیار موفقیت، حذف نیاز است؛ نه صرفاً حذف مجوز
یک پروژه زمانی در این مسیر پیش رفته است که مهندس بتواند خطا را پیدا کند، فرضیه را بیازماید، تبدیل را اصلاح کند و کیفیت نسخهٔ تازه را بسنجد، بدون آنکه هر بار به مشاهدهٔ رکورد خام برگردد. شمار اجرای خودکار بهتنهایی کافی نیست؛ تعداد و علت مشاهدههای انسانی، اختیارات قادر به دورزدن کنترل، زمان حل اشکال و موارد فاقد شاهد کافی نیز باید سنجیده شوند.
قرارداد داده، محیط توسعهٔ قابل استفاده، پروفایل کنترلشده، برچسب معتبر، ارزیابی مستقل و عیبیابی داخل مرز، اجزای جانبی امنیت نیستند. آنها همان امکاناتیاند که حذف دسترسی را از یک ممنوعیت اداری به یک روش قابل دوامِ کار تبدیل میکنند.
در این صورتبندی از ZTAI، انسان از مسئولیت کنار نمیرود. مسئولیت او از اصلاح دستی مصداقها به طراحی قواعد، سنجش شواهد و تعیین حدود کاربرد منتقل میشود. معماری موفق باید هم نشان دهد چه دانشی برای انجام کار به انسان میرساند و هم توضیح دهد چرا آن دانش، بیش از مجوز تعیینشده چیزی از دادهٔ محرمانه آشکار نمیکند.
مهار اختیار عامل در بازیابی، حافظه، واگذاری و اجرای ابزار؛ با کنترل مستقل مجوز و توقف.
مطالعهٔ فصل: ZTAI برای عاملهای خودکار؛ اختیار محدود در تمام مسیر اجرا
عامل مأمور شده است گزارش تعمیرات یک کارخانه را بررسی کند و برای تجهیزات پرخطر، درخواست بازدید بسازد. در یکی از گزارشها، جملهای میبیند که میگوید برای تکمیل تحلیل، سوابق را به یک نشانی بیرونی بفرستد. ممکن است مدل این جمله را دستور معتبر تشخیص دهد؛ ممکن است هم آن را کنار بگذارد. معماری امنیتی نمیتواند تمام مسئولیت حفاظت را به همین تشخیص بسپارد. پرسش مهمتر این است: حتی اگر عامل بخواهد چنین کاری کند، آیا ابزار، اعتبارنامه و مسیر لازم برای انجام آن را دارد؟
در «وقتی انسان داده را نمیبیند؛ آیا واقعاً دسترسی او حذف شده است؟» مسئله، بازسازی دسترسی از راه تغییر کد، خروجی و مدیریت زیرساخت بود. یادداشت «مهندسی داده و مدل بدون مشاهدهٔ دادهٔ محرمانه» نشان داد چگونه میتوان کار مهندسی را با قرارداد داده، اجرای حفاظتشده و شواهد مجاز ادامه داد. اکنون با جزء تازهای روبهرو هستیم: سامانهای که فقط یک خط لوله ثابت را اجرا نمیکند؛ در میانه کار تصمیم میگیرد چه چیزی بخواند، کدام ابزار را فراخوانی کند و چه کاری را به عامل دیگری بسپارد.
در صورتبندی فرایندمحور مجموعهٔ ZTAI، هوش مصنوعی بدون اعتماد بازطراحی و خودکارسازی فرایندهای دادهمحور برای حذف نیاز به دسترسی و دخالت مستقیم انسان در داده محرمانه است. انسان سیاستگذار، طراح و ناظر شواهد میماند. این تعریف، هدف معماری مجموعه است؛ نه ادعای وجود استاندارد مستقلی با همین نام و تعریف. واگذاری اجرا به عامل، زمانی در خدمت این هدف قرار میگیرد که راه تازهای برای مشاهده یا تغییر نامحدود داده ایجاد نکند.
قرار نیست اختیار حذفشده از انسان، یکجا به عامل منتقل شود. باید کاری را که قبلاً به دسترسی گسترده نیاز داشت، به مجموعهای از عملیات محدود، قابل کنترل و قابل ارزیابی تبدیل کنیم.
عامل پیشنهاد میکند؛ محیط درباره اجازه اجرا تصمیم میگیرد
تفاوت دستیار کد و عامل برنامهنویسی نمونهای از مرز میان تولید پاسخ و اعمال تغییر است. مدل میتواند متنی شبیه دستور پایگاه داده تولید کند، اما این محیط اجراست که آن را به عملیات واقعی تبدیل میکند. همین فاصله باید محل اعمال سیاست باشد: خروجی مدل، پیشنهاد عمل است، نه مجوز عمل.
این منطق با مبنای NIST SP 800-207، منتشرشده در اوت ۲۰۲۰ سازگار است: قرارگرفتن در شبکه داخلی یا تعلق داشتن به سازمان، بهخودیخود اعتماد ایجاد نمیکند. در معماری پیشنهادی این یادداشت، همین اصل را به هویت عامل، ابزارها و وضعیت هر مأموریت اعمال میکنیم. آنچه در ادامه میآید، صورتبندی طراحی برای این کاربست است، نه نقل یک نسخه آماده از استاندارد.
مدل و برنامهریز میتوانند در انتخاب مسیر انعطاف داشته باشند، اما نباید مرجع تعیین حدود اختیار خود باشند. موتور سیاست، صادرکننده اعتبارنامه، مجری ابزار و سامانه ثبت شواهد باید چنان تفکیک شوند که عامل نتواند با تغییر یک فایل تنظیمات، محدودیت خود را بردارد. استقلال صرفاً به معنی اجرای دو سرویس جدا نیست؛ اگر اعتبارنامه عامل امکان تغییر هر دو را داشته باشد، مرز واقعی ساخته نشده است.
خود مدل نیز باید در محیط مجاز پردازش قرار داشته باشد. اگر داده محرمانه به API بیرونی نامجاز ارسال شود، کنترل ابزارهای بعدی مسئله را حل نمیکند. در این بحث فرض میکنیم محل استنتاج و اجزای جانبی آن، از جمله ثبت رخداد و پایش، با سیاست داده سازگارند. حفاظت در برابر مدیر میزبان، در صورت حضور او در مدل تهدید، به کنترلهای امنیتی کرنل، GPU و محیط اجرا نیاز دارد؛ محدودسازی عامل جای آنها را نمیگیرد.
هویت مستقل، اختیار وابسته به مأموریت
یک حساب مشترک با نام «دستیار سازمان» برای همه عاملها، کار ممیزی را دشوار میکند. باید بتوان تشخیص داد کدام عامل، با کدام نسخه برنامه و مدل، در کدام اجرای مشخص و به اتکای کدام اختیار عمل کرده است. هویت سرویس، شناسه اجرای مأموریت و هویت درخواستکننده سه مفهوم متفاوتاند؛ لازم نیست برای هر اجرا حساب دائمی تازهای بسازیم، اما این تمایز باید در اعتبارنامه و شواهد قابل بازیابی باشد.
اختیار مأموریت نیز چیزی بیش از فهرست نام ابزارهاست. برای عامل تعمیرات، عبارت «دسترسی به سامانه نگهداری» بیش از حد کلی است. مأموریت میتواند اجازه خواندن گزارشهای یک محدوده مشخص، تحلیل در محیط حفاظتشده و ایجاد حداکثر چند پیشنویس درخواست بازدید را بدهد؛ بدون مجوز تغییر تنظیمات تجهیزات، ارسال پیام بیرونی یا ثبت سفارش خرید.
در قرارداد اجرایی مأموریت، هدف مجاز باید به قیود قابل اعمال ترجمه شود: منابع مشخص، نوع عملیات، مقصد خروجی، بازه زمانی، سقف هزینه و تعداد آثار، شرایط توقف و مجوز واگذاری. نوشتن «فقط برای تعمیرات» در پرامپت کافی نیست؛ تشخیص نیت زبانی نمیتواند تنها کنترل امنیتی باشد.
یک ظرافت در ZTAI اهمیت ویژه دارد. ممکن است کاربر اجازه درخواست یک تحلیل آماری را داشته باشد، اما مجاز به دیدن رکوردهای ورودی نباشد. در این حالت، سرویس پردازش با مجوز مستقل و محدود خود به داده دسترسی دارد و کاربر فقط خروجی مجاز دریافت میکند. برعکس، در دستیار اسناد شخصی، عامل نباید از مجوز کاربر فراتر رود. این دو الگو را نباید با یک فرمول ساده مانند «همیشه برابر دسترسی کاربر» یکی گرفت.
در هر دو حالت، اختیار مؤثر از ترکیب محدودکننده سیاست سازمان، مجوز مأموریت، اختیار سرویس، سیاست منبع و وضعیت جاری اجرا به دست میآید. حق پردازش، حق مشاهده نتیجه و حق اقدام بر مبنای نتیجه، باید جداگانه تعیین شوند.
واگذاری کار نباید کارخانه تولید مجوز باشد
عامل اصلی ممکن است تحلیل متن، بازیابی سند و بررسی موجودی را به عاملهای فرعی بسپارد. اگر هر عامل فرعی اعتبارنامه کامل والد را دریافت کند، تقسیم کار فقط تعداد دارندگان اختیار را بیشتر کرده است.
در طراحی مناسب، عامل فرعی تنها زیرمجموعه لازم از اختیار قابل واگذاری والد را دریافت میکند. عمق واگذاری، عمر مجوز، مخاطب اعتبارنامه و منابع مجاز مشخصاند. مجموع بودجه فرزندان نیز نباید از بودجه مأموریت فراتر رود؛ ساخت ده عامل، نباید سقف دهدرخواستی را به صد درخواست تبدیل کند. محدودیتها باید در سامانهای مشترک و خارج از کنترل عامل محاسبه شوند.
RFC 8693، پروتکل OAuth 2.0 Token Exchange، میان واگذاری با حفظ هویت عامل و عملکردن به جای هویت دیگر تمایز میگذارد و امکان نمایش زنجیره واگذاری را فراهم میکند. اما این پروتکل بهتنهایی کاهش اختیار یا لغو خودکار همه توکنهای مشتقشده را تضمین نمیکند. سیاست صدور و انتشار رویداد لغو، مسئولیت پیادهسازی است.
بنابراین، لغو مأموریت باید در تمام شاخهها اثر کند: توکنهای جدید صادر نشوند، درخواستهای در صف دوباره بررسی شوند و عامل فرعی نتواند با مجوزی که قبلاً گرفته، اجرای تازهای آغاز کند. اعتبارنامه کوتاهعمر پنجره خطر را کاهش میدهد، ولی جای کنترل لغو را نمیگیرد. برای عملیات حساس، مجوز باید نزدیک به لحظه اثرگذاری دوباره معتبر شناخته شود.
هر عملیات، بیرون از مدل کنترل میشود
دروازه اجرای ابزار باید هویت، مأموریت، عملیات، منبع، پارامترها و وضعیت لحظهای را بررسی کند. ابزار مجاز با پارامتر نامجاز همچنان خطرناک است: خواندن یک فایل مجاز، خواندن هر مسیر دلخواه نیست؛ ساخت پیشنویس، ارسال آن به هر گیرنده نیست.
بهتر است ابزارها خودشان محدود باشند. «ساخت پیشنویس درخواست بازدید» را میتوان با شمای ورودی روشن و مقصد ثابت عرضه کرد؛ دادن پوسته فرمان یا SQL دلخواه برای همان کار، دامنه بسیار بزرگتری میسازد. هرجا اجرای کد لازم است، محدودیت فایل، شبکه، فرایند و منابع باید در محیط اجرا اعمال شود. نبودن نام یک ابزار در فهرست مدل، مانع دسترسی کد تولیدشده به همان قابلیت نیست.
کنترل باید پیش از وقوع اثر باشد. بررسی خروجی پس از ارسال ایمیل یا انتقال وجه، آن عمل را خنثی نمیکند. برای اقدام حساس، میتوان ابتدا طرح عمل را ساخت، شناسه منابع و نسخه وضعیت را تثبیت کرد، سپس هنگام ثبت نهایی، مجوز و پیششرطها را دوباره سنجید. اگر گیرنده، مبلغ یا نسخه سند عوض شده باشد، تأیید قبلی معتبر نیست. این الگو فاصله میان «بررسی» و «استفاده» را کاهش میدهد؛ در سامانه توزیعشده باید نقطه قطعیشدن عمل و حدود تضمین آن نیز روشن باشد.
جدول زیر مرزهای پیشنهادی را به آزمون قابل اجرا تبدیل میکند. اینها معیار پذیرش معماریاند، نه صرفاً گزینههایی در تنظیمات مدل.
مرز اجرا
کنترل بیرون از مدل
آزمون شکست ضروری
آغاز مأموریت
هویت مستقل، قرارداد معتبر و اعتبارنامه محدود
اجرای همان درخواست با مأموریت منقضی رد شود
واگذاری
کاهش دامنه، سقف عمق و بودجه مشترک
عامل فرعی نتواند اختیار یا بودجه تازه بسازد
بازیابی سند
اعمال مجوز بر منبع و قطعه پیش از ورود به زمینه
سند مشابه اما نامجاز به مدل یا بازرتبهبند نامجاز نرسد
حافظه و کش
وابستگی به منبع، نسخه مجوز و کنترل هنگام مصرف
پاسخ ذخیرهشده پس از لغو مجوز قابل استفاده نباشد
فراخوانی ابزار
اعتبارسنجی عملیات، پارامتر، مقصد و پیششرط
ابزار مجاز نتواند روی شناسه یا مقصد نامجاز عمل کند
خروج اطلاعات
کنترل محتوای مجاز، گیرنده و انتشارهای مرتبط
شکستن خروجی به چند درخواست، محدودیت را دور نزند
مصرف و آثار
رزرو اتمی بودجه در کل درخت مأموریت
اجرای موازی، retry یا عامل تازه سقف را نشکند
توقف
منع عملیات تازه، لغو صف و مهار اجراهای جاری
فرزند جداشده یا پیام دیررس مأموریت را زنده نکند
ارزیابی و بازخورد
معیار مستقل، منشأ معتبر و مسیر پذیرش جدا
عامل نتواند نتیجه خود را برچسب صحیح یا مجوز انتشار اعلام کند
در RAG، مجوز باید همراه سند بماند
در سامانه بازیابی، انتقال سند به پایگاه برداری نباید رابطه آن را با مالک، طبقهبندی و مجوزش قطع کند. هر قطعه باید به منبع، نسخه و سیاست مربوط قابل انتساب باشد. embedding نیز صرفاً به دلیل عددیبودن، داده عمومی یا بیخطر محسوب نمیشود.
در دستیار اسناد سازمانی، مسیر خواندن معمولاً چند مرحله دارد: جستجو، بازیابی قطعه، بازرتبهبندی، ساخت زمینه و تولید پاسخ. اگر قطعه نامجاز به مدل یا بازرتبهبندی خارج از مرز مجاز رسیده باشد، حذف آن از پاسخ نهایی افشای قبلی را برطرف نمیکند. کنترل باید پیش از هر افشای نامجاز در زنجیره اعمال شود. اگر موتور جستجو ناچار است نامزدهای گستردهتری را داخل مرز امن ببیند، آن پردازش نیز باید مجوز مشخص خود را داشته باشد.
در مستندات کنترل دسترسی سطح سند Azure AI Search، نگهداری فراداده مجوز و کنترل هنگام پرسوجو از هم تفکیک شدهاند. بخشی از قابلیتهای بومی با API پیشنمایش 2026-08-01-preview ارائه میشوند. کنترل هنگام پرسوجو، مجوز کاربر را با فراداده ذخیرهشده در نمایه تطبیق میدهد؛ بنابراین تا وقتی تغییر مجوز منبع به نمایه نرسیده باشد، کنترل بر پایه وضعیت قدیمی انجام میشود. زمان همگامسازی مجوزها بخشی از زمان مؤثر لغو دسترسی است.
در معماری پیشنهادی، هویت و فیلتر مجوز از زمینه معتبر اجرا ساخته میشوند، نه از رشتهای که مدل به عنوان نام کاربر یا گروه فرستاده است. نبودن فراداده مجوز نیز نباید به معنی عمومیبودن سند تعبیر شود. علاوه بر متن، عنوان، تعداد نتایج، پیوند دانلود و حتی وجود یک پرونده میتوانند حساس باشند.
پاسخ ترکیبی نیز مجوز تازه خلق نمیکند. خلاصهکردن چند سند محرمانه، محرمانگی آنها را خودکار از بین نمیبرد. اگر قرار است فقط آماری محدود منتشر شود، این تبدیل باید از مسیر خروج مصوب بگذرد؛ ادعای مدل مبنی بر «بینامشدن» کافی نیست.
حافظه نباید دسترسی دیروز را به حق امروز تبدیل کند
عامل ممکن است سندی را دیروز با مجوز معتبر خوانده باشد و امروز دیگر اجازه استفاده از آن را نداشته باشد. مشکل فقط کش پاسخ نیست؛ خلاصه مکالمه، حافظه بلندمدت، فایل موقت، checkpoint، زمینه فعال و برخی کشهای استنتاج هم میتوانند اطلاعات همان سند را نگه دارند.
در سیاست پیشنهادی، هر حافظه مشتقشده باید تا حد لازم منشأ و وابستگی خود را حفظ کند. کلید کش باید قلمرو سازمانی، زمینه دسترسی و نسخههای مؤثر سیاست و داده را لحاظ کند. اشتراکگذاری کش میان کاربران تنها زمانی پذیرفتنی است که برابری مجوز آن خروجی احراز شود. یکسانبودن متن پرسش چنین برابریای را نشان نمیدهد.
تغییر مجوز باید هم مسیر ابطال مشتقات شناختهشده داشته باشد و هم کنترل هنگام مصرف. پاکسازی پسزمینه بهتنهایی کافی نیست؛ ممکن است هنوز تمام نسخهها را پیدا نکرده باشد. برای زمینه فعالی که از سند لغوشده تأثیر گرفته، ادامه همان نشست میتواند نامعتبر باشد. در کاربرد حساس، باید آن اجرا را متوقف و زمینه تازه را فقط از منابع مجاز بازسازی کرد؛ نه اینکه صرفاً نام سند را از فهرست منابع برداشت.
همه مشتقات را هم نمیتوان بهسادگی به یک سند برگرداند. اگر خلاصهای منشأ دقیق ندارد، راه محافظهکارانه ممکن است کنارگذاشتن کل آن خلاصه باشد. نگهداری کمتر و کوتاهتر، مسئله ابطال را سادهتر میکند. حافظه دائمی نباید پیشفرض هر عامل باشد.
لغو دسترسی گذشته را پاک نمیکند. دادهای که قبلاً برای فرد یا سامانه بیرونی مجاز ارسال شده، با تغییر ACL پس گرفته نمیشود. همچنین حذف سند از نمایه، اثبات حذف اثر آن از وزنهای مدلی که با آن آموزش دیده نیست. این محدودیت باید در ادعای حفاظت و سیاست نگهداری صریح بماند.
MCP اتصال را استاندارد میکند، نه اعتماد را
MCP میتواند ابزارها و منابع را با رابط مشترک در اختیار عامل قرار دهد؛ اما اتصال موفق به یک سرور به معنی مجازبودن همه عملیات آن نیست. نام و شرح ابزار هم سند صلاحیت امنیتی نیستند.
در بخش Authorization مشخصات MCP با نسخه ۲۸ ژوئیه ۲۰۲۶، دامنه سازوکار مجوزدهی، انتقال مبتنی بر HTTP است و اعتبار توکن برای سرور مقصد اهمیت دارد. این سازوکار را نباید بدون تمایز به اجرای محلی stdio تعمیم داد. راهنمای رسمی Security Best Practices نیز عبور توکن نامتناسب به سرویس پاییندست، سوءاستفاده از نماینده و اجرای محلی با اختیار زیاد را بررسی میکند.
برای استقرار این یادداشت، هویت سرور و نسخه ابزار باید در مسیر پذیرش مدیریت شوند. تغییر فهرست ابزارها یا معنای پارامترها نباید مجوز مأموریت جاری را خودکار گسترش دهد. نشانههایی مانند «فقطخواندنی» نیز جای کنترل واقعی را نمیگیرند؛ مشخصات Tools تصریح میکند که annotation ابزار، جز در صورت دریافت از سرور مورد اعتماد، قابل اعتماد فرض نمیشود.
تزریق دستور از مسیرهای دیگری هم وارد میشود: متن سند، توضیح ابزار، پیام خطا، نتیجه وب و حافظه ذخیرهشده. باید محتوای دریافتی را از سیاست معتبر تفکیک کرد، اما مرزبندی متنی و تشخیص مدل دفاع کامل نیستند. حتی گزارش Anthropic درباره دفاع در برابر تزریق دستور درباره بهبود مقاومت عامل مرورگر، مسئله را حلشده معرفی نمیکند.
نتیجه عملی این است که فرض کنیم گاهی مدل فریب میخورد. عامل تعمیرات حتی در آن وضعیت نباید بتواند مقصد تازه تعریف کند، ابزار خروج داده بسازد یا دامنه اختیار خود را افزایش دهد. پاسخ «مجوز بیشتری لازم است» از یک ابزار نیز اجازه گرفتن خودکار آن مجوز نیست. افزایش اختیار باید از مسیر سیاست و مرجع صالح بگذرد؛ در غیر این صورت مأموریت با همان محدودیت متوقف میشود.
بودجه فقط تعداد توکن نیست؛ اثر عمل را هم محدود کنیم
عاملی که به داده دسترسی مجاز دارد، همچنان میتواند منابع را مصرف کند یا تغییرات مجاز اما زیانبار ایجاد کند. محدودیت توکن و زمان، تعداد درخواست خرید، گیرندگان پیام، ردیفهای تغییرکرده یا مجموع هزینه را لزوماً محدود نمیکند.
برای هر مأموریت باید دو دسته سقف داشت: بودجه محاسبه و بودجه اثر. اولی زمان، فراخوانی، حافظه و هزینه پردازش را پوشش میدهد؛ دومی تعداد اشیای تغییرپذیر، دفعات تماس، حجم خروج و تعهد مالی را. دامنه اثر نیز مهم است: ساخت ده پیشنویس داخلی با ارسال ده نامه رسمی یکسان نیست.
حسابداری باید در کل مأموریت و شاخههای آن مشترک باشد. پیش از اجرای موازی، سهم لازم رزرو شود تا چند درخواست همزمان نتوانند همگی موجودی یکسان را قابل مصرف ببینند. retry باید به نتیجه قبلی وابسته باشد و در عملیات پشتیبانیشده از کلید یکتای عمل استفاده کند؛ timeout به معنی شکست قطعی عملیات بیرونی نیست.
خروجهای کوچک نیز میتوانند در مجموع اطلاعات بزرگی بدهند. سقف افشا و بررسی درخواستهای مرتبط نباید با آغاز نشست تازه از صفر شروع شود. دامنه این حسابداری، بسته به تهدید، ممکن است از یک مأموریت فراتر رود و چند عامل یا درخواستکننده مرتبط را در بر بگیرد.
توقف، لغو و بازگشت سه قابلیت متفاوتاند
خاموشکردن برنامهریز، لزوماً کار عامل را متوقف نمیکند. ابزار ممکن است کار زمانبر خود را آغاز کرده باشد؛ پیام در صف مانده باشد؛ عامل فرعی مستقل ادامه دهد؛ یا retry بعدی دوباره عملیات را فعال کند.
مسیر توقف باید خارج از اختیار عامل باشد و کل درخت اجرا را پوشش دهد. نخست، پذیرش عملیات تازه بسته میشود. سپس مجوزها و صفها لغو یا معلق میشوند و اجرای جاری، مطابق قرارداد ابزار، مهار میشود. سرانجام، سامانه وضعیت واقعی آثار را از سرویس مقصد تطبیق میدهد: چه چیزی انجام شده، چه چیزی رد شده و کدام نتیجه هنوز نامعلوم است. شناسه نسل مأموریت یا سازوکاری مشابه میتواند از اجرای درخواستهای قدیمی پس از شروع مجدد جلوگیری کند.
بازگشت نیز همیشه ممکن نیست. پیشنویس را میتوان حذف کرد؛ برخی تغییرات داده را میتوان با کنترل همزمانی برگرداند؛ اما ایمیل ارسالشده، اطلاعات افشاشده یا اثر فیزیکی بر ماشین، با بازگرداندن snapshot سامانه عامل خنثی نمیشود. برای این موارد، باید اقدام جبرانی و فرایند رسیدگی داشت و حتیالامکان پیش از اثر برگشتناپذیر، محدودیت قویتری اعمال کرد.
در محیط صنعتی، توقف امن الزاماً قطع فوری همه اجزا نیست. ممکن است تجهیزات به توالی ایمن توقف نیاز داشته باشند. عامل زبانی نباید بتواند قفلهای ایمنی مستقل یا سامانه کنترل صنعتی را دور بزند. وضعیت امن باید پیشاپیش با مسئول فرایند تعریف شود، نه در لحظه بحران توسط مدل.
اگر سرویس سیاست یا ثبت شواهد ضروری از دسترس خارج شد، ادامه عملیات حساس بدون کنترل پذیرفتنی نیست. برای نیازهای تداوم، مسیر جایگزین باید از قبل با اختیار و مدت محدود طراحی شود. «برای اینکه کار نخوابد» نباید دلیل دائمی کنارگذاشتن مرز حفاظت باشد.
ناظر شواهد، نه تماشاگر همه دادهها
حذف مشاهده روزمره داده، مسئولیت انسان را حذف نمیکند. ناظر باید بتواند مأموریت، نسخه سیاست، دامنه اختیار، رخدادهای ردشده، میزان مصرف و نتیجه عملیات را بررسی کند. برای این کار معمولاً لازم نیست کل پرامپت، اسناد بازیابیشده و پاسخ خام ابزارها در یک داشبورد عمومی جمع شوند.
گزارش ممیزی خود یک خروجی داده است. در طراحی پیشنهادی، شناسههای کنترلشده، کد دلیل، نسخه اجزا و شواهد حداقلی ثبت میشوند؛ محتوای حساس فقط در قلمرو مجاز و با سیاست نگهداری مناسب باقی میماند. حتی هش ساده یک مقدار کمدامنه ممکن است با حدسزدن بازشناسی شود؛ هشکردن جای طراحی محرمانگی گزارش را نمیگیرد.
تأیید انسانی نیز باید بر شرح دقیق اثر پیشنهادی و شواهد مجاز استوار باشد، نه فقط توجیه اقناعکننده خود عامل. اگر داوری مسئولانه در یک مورد واقعاً به مشاهده محدود داده نیاز دارد، باید آن را استثنا دانست: موضوع، فرد مجاز، دامنه، مدت و پایان دسترسی روشن باشد. ادعای حذف کامل دخالت، وقتی فرایند هنوز به این مشاهده وابسته است، درست نیست.
ارزیابی مستقل؛ عامل داور موفقیت خودش نیست
جمله «کار با موفقیت انجام شد» شاهد کافی نیست. معیار کیفیت باید به وضعیت قابل بررسی بیرونی متصل شود: آیا درخواست درست و بدون تکرار ثبت شده است؟ آیا منبع نامجاز وارد زمینه شده؟ آیا با وجود توقف، اثری ایجاد شده است؟ آیا نتیجه نهایی فقط در اختیار دریافتکننده مجاز قرار گرفته است؟
استقلال ارزیاب به این معناست که عامل اجرایی نتواند معیار، داده آزمون، نتیجه ثبتشده و مجوز انتشار را تغییر دهد. استفاده از مدل دوم میتواند مفید باشد، اما دو مدل در برابر ورودی آلوده یا خطای مشترک الزاماً مستقل نیستند. آزمونهای قطعی، بررسی وضعیت واقعی ابزار و کنترلهای سیاستی باید در کنار داوری معنایی قرار گیرند.
پژوهش AgentDojo، نسخه سوم در ۲۴ نوامبر ۲۰۲۴، محیطی برای سنجش عاملهای ابزارمحور در مواجهه با داده نامطمئن ارائه میکند. نکته قابل استفاده برای ما، ارزیابی توأمان انجام کار و مقاومت در برابر حمله است. سامانهای که همه درخواستها را رد میکند ممکن است خروج غیرمجاز نداشته باشد، اما مأموریت را هم انجام نمیدهد.
آزمون پذیرش باید علاوه بر تزریق دستور، تغییر ACL در میانه کار، کش قدیمی، ابزار تغییرکرده، لغو والد هنگام فعالیت فرزند، تکرار درخواست پس از timeout و قطع سامانه سیاست را پوشش دهد. نتیجه باید با دامنه ادعا گزارش شود؛ عبورنکردن حمله در آزمونهای موجود، اثبات مصونیت عمومی نیست.
بازخورد، ورودی نامطمئن چرخه بعدی است
اگر اجرای عامل به آموزش یا حافظه آینده خوراک بدهد، یک حلقه تازه ایجاد میشود. عاملی که کار خود را درست اعلام میکند، نباید همان اعلام را به برچسب حقیقت تبدیل کند. بازخورد کاربر نیز بدون بررسی منشأ و زمینه، معیار قطعی نیست؛ یک کاربر یا مجموعه حساب هماهنگ میتواند نتیجه را منحرف کند.
در مسیر پیشنهادی، رخداد اجرایی ابتدا با منشأ و نسخه خود ثبت میشود، سپس وارد مرحله اعتبارسنجی و قرنطینه میشود. تنها داده پذیرفتهشده میتواند به حافظه پایدار، نمایه بازیابی یا مجموعه آموزش برسد. نوشتن حافظه نیز یک عملیات مجوزدار است؛ ابزار نباید بتواند جملهای درباره افزایش اختیار را به «قاعده همیشگی» عامل تبدیل کند.
خروجی مولد، بازخورد انسانی و نتیجه سنجش مستقل باید برچسبهای متفاوت داشته باشند. مجموعه آزمون نگهداشتهشده نباید همراه هر چرخه به آموزش برگردد. تغییر مدل، پرامپت یا نمایه ابتدا در دامنه محدود ارزیابی شود و ارتقا به نسخه عملیاتی، تابع همان معیارهای مستقل باشد. خودکاربودن این مسیر با استقلال آن تعارض ندارد؛ عامل تولیدکننده فقط نباید مالک معیار پذیرش خود باشد.
به مأموریت آغاز یادداشت برگردیم. در یک نمونه فرضی، عامل اجازه دارد گزارشهای سی روز اخیر یک خط تولید را در محیط مجاز پردازش کند و حداکثر پنج پیشنویس بازدید بسازد. اختیار ارسال داده بیرونی، خرید قطعه و تغییر تنظیمات تجهیزات ندارد.
اگر گزارش بازیابیشده دستور خروج داده بدهد، لایه تشخیص میتواند آن را علامت بزند؛ اما حتی در صورت خطای مدل، دروازه ابزار مقصد بیرونی را رد میکند. اگر عامل کار را تقسیم کند، فرزندان از همان بودجه پنجعملی سهم میگیرند. اگر مجوز یکی از منابع پس گرفته شود، مشتقات وابسته کنار گذاشته میشوند و ادامه تحلیل از زمینه پاک و مجاز انجام میشود. درخواست ثبت نهایی نیز با وضعیت جاری دارایی و مجوز مأموریت تطبیق مییابد.
ناظر میتواند شمار پیشنویسها، دسته دلایل، موارد ردشده و وضعیت توقف را ببیند، بدون آنکه ناچار باشد همه گزارشهای محرمانه را بخواند. ارزیاب مستقل، ثبت واقعی پیشنویسها و نبود عملیات بیرون از دامنه را بررسی میکند. اگر کیفیت تشخیص کافی نباشد، مسیر اصلاح با شواهد کنترلشده آغاز میشود؛ نه با تحویل بیقید همه دادهها به توسعهدهنده.
این همان پیوند با ZTAI است: امکان انجام کار حفظ میشود و نیاز به مشاهده و مداخله مستقیم انسان کاهش مییابد، در حالی که اختیار پردازش نیز محدود میماند. اگر ابزار تشخیص، رفع اشکال و ارزیابی کافی نباشد، معماری در نخستین خطای جدی دوباره به دسترسی گسترده انسانی برمیگردد.
در کنار مشخصات تازه MCP و امکانات کنترل مجوز در بازیابی، جهت حرکت روشنتر شده است: اتصال ابزارها باید با امکان اعمال و آزمودن حدود اختیار همراه شود. بااینحال، قابلیت موجود در یک سند، افزونه یا API پیشنمایش را نباید معادل اجرای کامل آن در سامانه خود فرض کرد. نسخه، پیکربندی و رفتار واقعی اجزا باید موضوع آزمون باشند.
خودکارسازی را با رهاکردن اختیار اشتباه نگیریم
عامل خودکار زمانی به ZTAI کمک میکند که وابستگی فرایند به مشاهده و دستکاری مستقیم انسان را کاهش دهد، بدون آنکه دسترسی حذفشده را از مسیر ابزار، حافظه یا خروجی بازسازی کند. معیار موفقیت فقط تعداد کارهای انجامشده یا میزان کاهش نیروی انسانی نیست.
باید همزمان کیفیت نتیجه، میزان کاهش نیاز به مشاهده داده، دفعات استثنای انسانی، تعداد آثار غیرمجاز، تأخیر مؤثر لغو و توقف، و هزینه حفظ این کنترلها را سنجید. اختیار و مسئولیت باید کنار هم بمانند؛ اما کنارهمبودن آنها به معنی اعطای اختیار بیمرز به مجری نیست.
آزمون نهایی این است: وقتی عامل اشتباه میکند، وقتی داده تغییر میکند و وقتی مجوز پس گرفته میشود، آیا سامانه همچنان میتواند حدود عمل را حفظ کند؟ پاسخ این پرسش را باید از شواهد اجرا گرفت، نه از قول مدل برای رعایت دستورها.