آرشیو

نوشته‌ها و یادداشت‌ها

تحلیل‌های فنی و مدیریتی؛ گاهی هم سفرنامه و دلنوشته.

همهٔ موضوع‌ها و دسته‌ها
نمایش آرشیو

صفحه ۲ / ۷ · ۷۵ نوشته

مدل‌های زبانی

انتشار ۷ مرداد ۱۴۰۵ · بازبینی ۲۵ شهریور ۱۴۰۵ · ۱۸ دقیقه
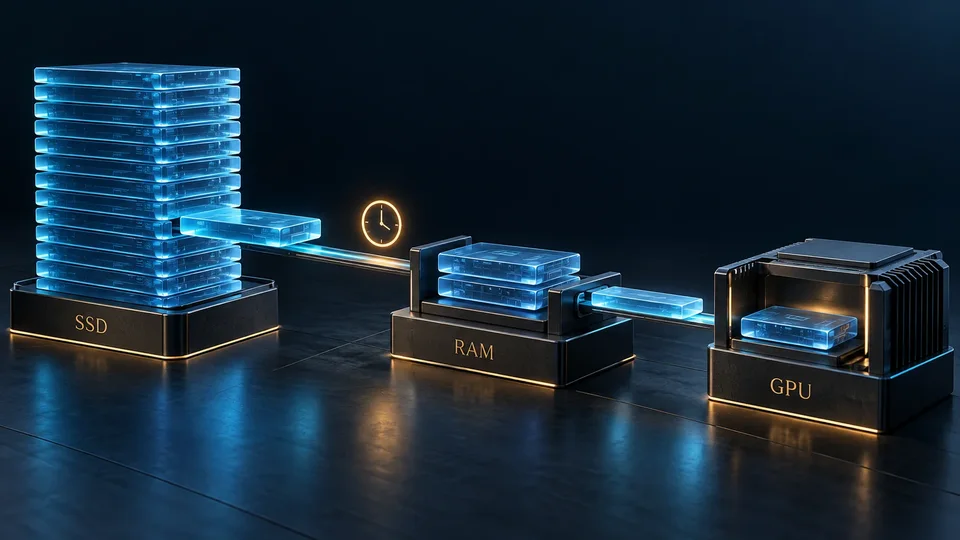
AirLLM و اجرای لایه‌به‌لایه؛ مدل بزرگ با حافظهٔ کم، با چه هزینه‌ای؟

AirLLM چگونه مدل بزرگ را با VRAM کم اجرا می‌کند؟ هزینهٔ انتقال وزن، RAM و SSD، حافظهٔ کانتکست و تفاوت کاربرد پژوهشی با سرویس سازمانی؛ همراه با چهار جدول و بررسی آموزش LoRA. ادامه مطلب ←
امنیت

انتشار ۲۴ شهریور ۱۴۰۵ · ۱۴ دقیقه
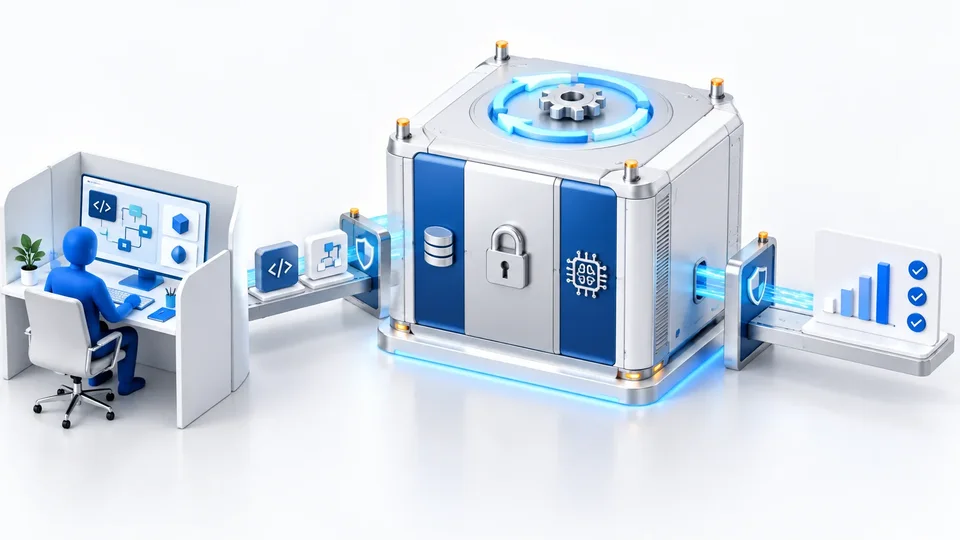
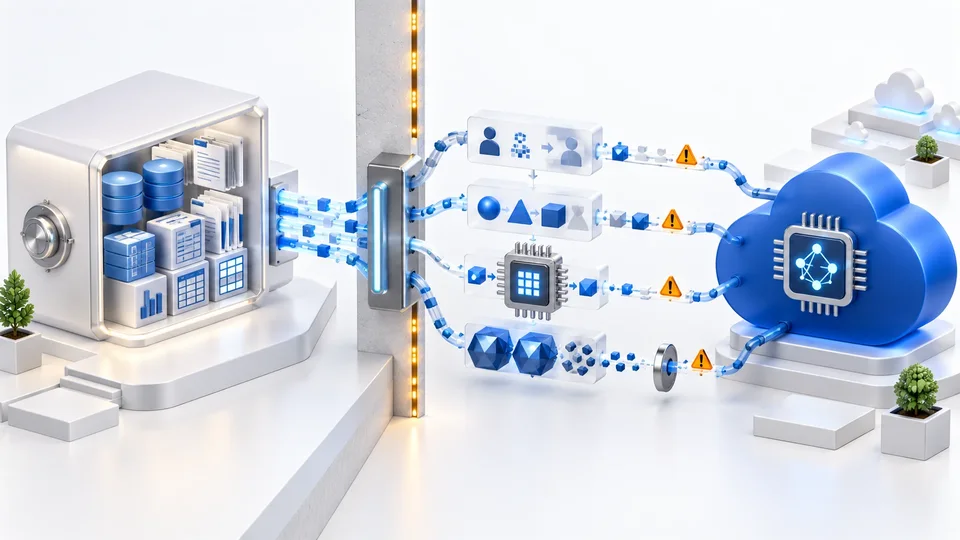
حفظ محرمانگی داده در استفاده از APIهای عمومی

آیا حذف نام مشتری یا تعهد ارائه‌دهنده به استفاده‌نکردن از داده برای آموزش، برای حفظ محرمانگی کافی است؟ مسئله زمانی دشوار می‌شود که پاسخ مفید مدل به همان معنا و روابطی وابسته باشد که سازمان اجازهٔ افشای آن‌ها را ندارد. این یادداشت، روش‌های موجود را از کمینه‌سازی و نام مستعار تا تبدیل معنایی، محیط اجرای مورد اعتماد و رمزنگاری همریخت مقایسه می‌کند؛ هر روش چه چیزی را پنهان می‌کند، با API معمولی چقدر سازگار است و در برابر چه مخاطراتی همچنان محدود می‌ماند؟ ادامه مطلب ←
امنیت

انتشار ۲۲ شهریور ۱۴۰۵ · ۲۵ دقیقه
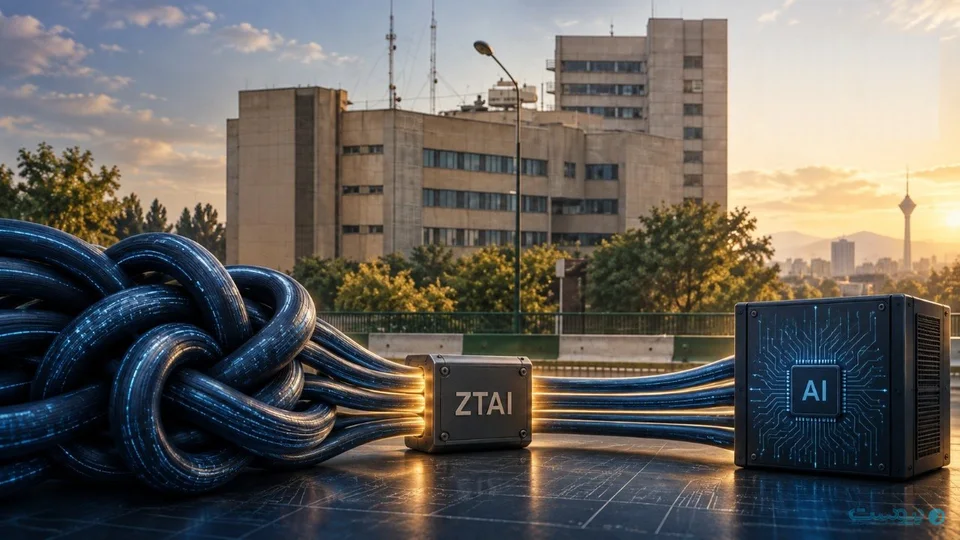
مهندسی داده و مدل بدون مشاهدهٔ دادهٔ محرمانه

اگر مهندس داده و دانشمند داده رکوردهای واقعی را نبینند، چگونه خطا را پیدا می‌کنند، ویژگی می‌سازند و دربارهٔ کیفیت مدل تصمیم می‌گیرند؟ این یادداشت، از قرارداد داده و توسعه با دادهٔ آزمایشی تا ارزیابی مستقل و عیب‌یابی در مرز امن، یک چرخهٔ عملی را صورت‌بندی می‌کند؛ با تفکیک روشن میان امکان خودکارسازی، خطر افشای خروجی و مواردی که هنوز به مشاهدهٔ انسانیِ محدود نیاز دارند. ادامه مطلب ←
حکمرانی داده

انتشار ۲۱ شهریور ۱۴۰۵ · ۱۱ دقیقه
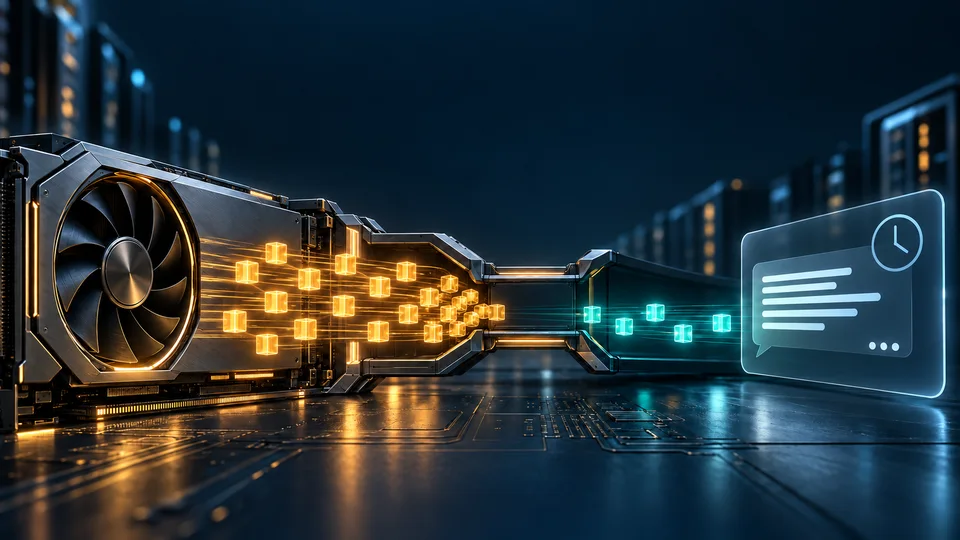
گره‌گشایی از هوش مصنوعی؛ تدبیری در دستان سازمان فناوری اطلاعات

داده وجود دارد و مسئله هم روشن است؛ پس چرا پروژه‌های هوش مصنوعی پیش از آزمون فنی، پشت درِ دسترسی به داده متوقف می‌شوند؟ این یادداشت از نقد محرمانگی و تعارض منافع عبور می‌کند و مسیری اجرایی برای استفاده مجاز از داده، بدون الزام به مشاهده و دریافت آن توسط انسان، پیشنهاد می‌دهد. محور پیشنهاد، نقش سازمان فناوری اطلاعات در طراحی معماری پردازش حفاظت‌شده و همکاری با دستگاه میزبان، شرکت مجری و نهادهای حامی است. یک کاربست واقعی می‌تواند هم مسئله‌ای صنعتی یا خدماتی را حل کند و هم الگویی آزموده‌شده برای همکاری‌های بعدی بسازد. تقسیم مسئولیت، هزینه آماده‌سازی داده و معیار سنجش نتیجه، تعیین می‌کنند این مسیر به بهره‌برداری برسد یا در هماهنگی‌های اداری متوقف بماند. ادامه مطلب ←
زیرساخت هوش مصنوعی

انتشار ۲۱ شهریور ۱۴۰۵ · ۱۴ دقیقه
چرا سریع‌ترین GPU لزوماً سریع‌ترین پاسخ را نمی‌دهد؟

توان پردازشی بیشتر یا نرخ توکن بالاتر، همیشه به پاسخ سریع‌تر منتهی نمی‌شود. تفاوت زمان آغاز و تکمیل پاسخ، نقش حافظه و همزمانی، تقسیم کار GPU و LPU و هزینهٔ ارتباطات را بررسی می‌کنیم تا معیار انتخاب زیرساخت، ظرفیت خدمت‌دهی با کیفیت و تأخیر مورد نیاز باشد. ادامه مطلب ←
سیاست‌گذاری هوش مصنوعی

انتشار ۱۸ شهریور ۱۴۰۵ · ۱۵ دقیقه
سازمان ملی هوش مصنوعی؛ از تأسیس قانونی تا اثرگذاری ملی

سازمان ملی هوش مصنوعی پشتوانه قانونی تازه‌ای یافته است؛ اما وقتی هر دستگاه اولویت، بودجه و ملاحظات خود را دارد، این سازمان چگونه می‌تواند تصمیمی ملی را به اجرا برساند؟ ممکن است همه دستگاه‌ها به وظایف بخشی خود عمل کنند و حاصل جمع عملکردشان، توقف توسعه باشد. این یادداشت از همین تعارض آغاز می‌کند و با مرور تجربه نهادهای متمرکز در جهان، به طراحی سازمانی کوچک و چابک می‌پردازد که اختیار حل اختلاف و مطالبه نتیجه داشته باشد. پشتوانه مستقیم رئیس‌جمهور، پیوند اختیار با بودجه، انتخاب مدیری مستقل و مشارکت مؤثر بخش خصوصی، اجزای این پیشنهادند. مسئله تعیین‌کننده این است که چگونه می‌توان به سازمان قدرت راهبری داد، بدون آنکه درگیر تصدی‌گری شود یا لایه‌ای تازه به دیوان‌سالاری کشور بیفزاید. ادامه مطلب ←
امنیت

انتشار ۱۸ شهریور ۱۴۰۵ · ۱۸ دقیقه
وقتی انسان داده را نمی‌بیند؛ آیا واقعاً دسترسی او حذف شده است؟

حذف دسترسی مستقیم انسان به دادهٔ محرمانه، به کنترل اختیار تغییر کد، خروج اطلاعات و مدیریت زیرساخت وابسته است. این یادداشت نشان می‌دهد ZTAI چگونه باید مسیرهای غیرمستقیم دسترسی را نیز محدود و قابل ممیزی کند. ادامه مطلب ←
تنظیم‌گری داده

انتشار ۱۷ شهریور ۱۴۰۵ · ۱۱ دقیقه
گره کور داده برای هوش مصنوعی؛ به دست باز کنیم یا دندان؟

مدلی که باید خرابی تجهیزات یک پالایشگاه را پیش‌بینی کند یا کیفیت خدمات درمانی را بهبود دهد، به داده‌های واقعی نیاز دارد؛ اما مدیر دستگاهی که این داده‌ها را نگه می‌دارد، ممکن است هزینه همکاری را بیش از هزینه امتناع بداند. وقتی منفعت استفاده از داده به دیگران می‌رسد و مسئولیت افشای احتمالی متوجه مدیر می‌شود، تکلیف قانونی به تبادل داده چقدر راهگشاست؟ این یادداشت با روایتی از همین نگرانی، به ریشه‌های حقوقی محرمانگی، تعارض منافع دستگاه‌ها و محدودیت قوانین موجود می‌پردازد. سپس امکان تفکیک حق پردازش از دریافت داده خام را بررسی می‌کند: چگونه می‌توان داده را محرمانه نگه داشت و استفاده‌ای مشخص و کنترل‌شده از آن را مجاز کرد؟ پاسخ، به ظرفیت‌های فنی و قانونی امروز و قواعد تازه‌ای برای تعیین حدود دسترسی، مسئولیت و حق اعتراض گره خورده است. ادامه مطلب ←
مدل‌های زبانی

انتشار ۱۷ شهریور ۱۴۰۵ · ۲۱ دقیقه
از یک کاربر تا سرویس سازمانی؛ چه زمانی مدل، تعداد نسخه‌ها یا GPU را تغییر دهیم؟

از صف و کانتکست تا تکثیر مدل و تحمل خرابی؛ راهنمای رشد اقتصادی سرویس سازمانی با GPU متناسب، نمونه‌های مستقل و ظرفیت ابری با پرداخت به‌اندازهٔ مصرف، همراه با مثال‌های عددی. ادامه مطلب ←
تجربه‌نگاری

انتشار ۱۴ شهریور ۱۴۰۵ ·

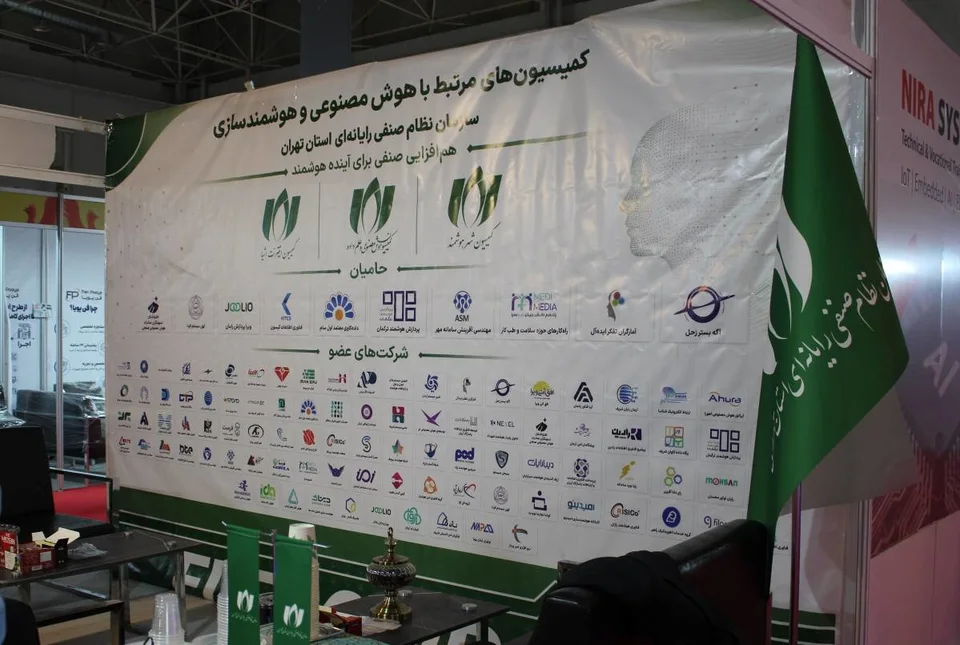
الکامپ ۲۹: از نمایش فناوری تا ضرورت هم‌افزایی

روایتی از چند روز حضور کمیسیون هوش مصنوعی و علم داده نصر تهران در الکامپ و اینوتکس؛ از مواجهه با نیازهای کسب‌وکارها و گفت‌وگو با سیاست‌گذاران تا تجربه همکاری میان کمیسیون‌ها و استان‌ها. ادامه مطلب ←
محصول و فناوری

انتشار ۱ شهریور ۱۴۰۵ · ۱۰ دقیقه

«عیار هومص»؛ دستیاری برای استارتاپ‌ها و سرمایه‌گذاران

عیار هومص تلاش می‌کند فاصله میان یک فناوری امیدوارکننده و پرونده‌ای قابل دفاع برای سرمایه‌گذاری را با داده ساخت‌یافته، ارزیابی مستمر، تحلیل مالی و حفظ نقش داوری انسانی کمتر کند. ادامه مطلب ←